
Key Takeaways – šta je najbitnije u ovom tekstu
-
Brzina isporuke bez pouzdanosti stvara negativnu poslovnu vrednost. Agile metodologija je naučila timove kako da brzo isporučuju softver, ali funkcionalnost koja ne radi u produkciji ili obara sistem pod opterećenjem korisniku ne vredi ništa.
-
Site Reliability Engineering (SRE) nije samo novo ime za sistem administratore. Nastao u kompaniji Google, SRE predstavlja primenu softverskog inženjerstva na operativne probleme, sa ciljem da se pouzdanost meri, automatizuje i ugradi u sam proces razvoja.
-
Error Budget (budžet grešaka) je tačka gde se susreću Agile i SRE. Umesto beskonačnih političkih rasprava između Product Owner-a i operativnog tima oko toga da li sistem sme u produkciju, budžet grešaka daje jasnu, matematičku granicu rizika koju obe strane prihvataju.
-
Mit o izboru između brzine i stabilnosti je odavno srušen. Višegodišnja istraživanja tima DORA (DevOps Research and Assessment) pokazuju da najuspešnije tehnološke organizacije istovremeno postižu i najbržu isporuku koda i najvišu stabilnost sistema.
-
Eliminacija manuelnog ponavljanja (Toil) oslobađa kapacitet za inovacije. Google-ovo pravilo da SRE inženjeri najviše 50% vremena smeju da troše na operativni rad, dok ostatak mora ići na pisanje koda i automatizaciju, direktno sprečava sagorevanje timova i gomilanje tehničkog duga.
-
U eri AI agenata i ubrzanog generisanja koda, SRE postaje kritična kočnica i zaštita. Kako alati veštačke inteligencije višestruko povećavaju količinu koda koji ulazi u repozitorijume, automatizovane provere pouzdanosti i autonomni oporavak sistema postaju jedini način da produkcija preživi.
Iluzija brzine i tiha cena nestabilnosti
Petak je, 16:30. Agile tim upravo zatvara dvonedeljni sprint. Svi tiketi su u koloni „Done“, brzina tima (velocity) je na istorijskom maksimumu, Product Owner zadovoljno klima glavom na demo prezentaciji, a nova funkcionalnost za brzu naplatu kreće u produkciju.
Subota je, 11:15. Kampanja na društvenim mrežama je krenula, saobraćaj skače za trista procenata, baza podataka ulazi u stanje blokade zbog neoptimizovanog upita iz tog novog koda, a ceo sistem za naplatu pada. Inženjeri koji su dežurni tog vikenda provode narednih šest sati u panici, gase požar, ručno vraćaju prethodnu verziju softvera i gledaju kako kompanija gubi desetine hiljada evra po satu.
Ovaj scenario nije izuzetak. To je svakodnevica u stotinama IT kompanija koje su usvojile Agile samo na papiru, tretirajući ga kao fabriku za štancovanje novih funkcionalnosti, dok su pouzdanost, skalabilnost i održavanje sistema gurnuli pod tepih kao „tuđi problem“.
U srži tog problema leži jedan od najstarijih sukoba u softverskoj industriji. Sa jedne strane stoje razvojni i produkt timovi čiji je glavni cilj promena: što brže izbaciti nove opcije na tržište, testirati hipoteze i odgovoriti na zahteve kupaca. Sa druge strane stoje ljudi zaduženi za infrastrukturu i produkciju, čiji je osnovni instinkt da sačuvaju stabilnost – a najlakši način da sistem ostane stabilan jeste da se u njemu ništa ne menja.
Upravo na toj liniji fronta nastao je Site Reliability Engineering (SRE) (inženjering pouzdanosti sistema). Iako se o njemu često priča kao o skupu alata za nadzor servera ili naprednom sistem administratoru, SRE je zapravo nešto mnogo dublje: to je nedostajuća karika koja Agile razvoju daje neophodnu disciplinu kako brzina isporuke ne bi uništila sam biznis.
Šta je zapravo Site Reliability Engineering i zašto nije samo preimenovani SysAdmin?
Početkom dvehiljaditih godina, dok je Google rastao brzinom koju tradicionalni modeli upravljanja serverima nisu mogli da isprate, Ben Treynor Sloss je postavio jednostavno, ali revolucionarno pitanje: šta se dešava kada zadatak vođenja ogromnih produkcionih sistema poverite softverskom inženjeru?
Odgovor je postao temelj discipline koju danas poznajemo kao Site Reliability Engineering. Umesto da zapošljava armiju administratora koji ručno klikću po konzolama, gase požare i reaguju tek kada korisnici prijave da sajt ne radi, Google je počeo da tretira operativne probleme kao probleme softverskog inženjerstva. Kako je detaljno opisano u čuvenoj Google SRE knjizi, suština ovog pristupa nije u tome da ljudi rade brže kada sistem padne, već da napišu softver koji će sprečiti da do pada uopšte dođe ili koji će sistem oporaviti samostalno, bez ljudske intervencije.
Ovde je važno razbiti jednu čestu zabludu na domaćem i regionalnom tržištu: SRE nije samo kozmetička promena naziva radnog mesta. Ako kompanija promeni naziv pozicije iz „System Administrator“ u „SRE Engineer“, a ti ljudi i dalje provode osam sati dnevno ručno restartujući servise, podešavajući mrežne rute i odobravajući tikete za pristup bazi, tu nema ni traga od pravog SRE-a. To je samo skupa promena vizitkarte.
Takođe, često se postavlja pitanje kakav je odnos između SRE-a i DevOps kulture. Najprecizniju definiciju dali su sami inženjeri iz Google-a koristeći programersku analogiju: class SRE implements interface DevOps. DevOps je skup principa i kultura koja ruši zidove između razvoja i operacija, promovišući zajedničku odgovornost i kontinuiranu isporuku. SRE je konkretna, inženjerska implementacija tih principa sa jasnim metrikama, matematičkim modelima rizika i strogim pravilima o tome kako se balansira između razvoja novih opcija i održavanja postojećeg sistema.
Agile bez pouzdanosti je samo brži put do tehničkog duga
Kada je 2001. godine objavljen tekst Agile Manifesta, njegov glavni cilj bio je da oslobodi razvojne timove od tromih, birokratskih procesa u kojima se softver planirao godinama unapred, a isporučivao prekasno. Fokus je prebačen na ljude, saradnju sa klijentom, brze iteracije i prilagođavanje promenama.
Međutim, dve i po decenije kasnije, u praksi često gledamo karikaturu Agile-a. Mnogi timovi su opsednuti brzinom zatvaranja zadataka u sprintu, dok se nefunkcionalni zahtevi (Non-Functional Requirements) – poput vremena odziva sistema, ponašanja pod velikim opterećenjem, potrošnje memorije ili otpornosti na pad eksternih servisa – uporno odlažu za „neki sledeći sprint“ koji nikada ne dođe.
Tu nastaje suštinski poslovni problem. Sa stanovišta krajnjeg korisnika, pouzdanost je najvažnija funkcionalnost svakog softvera. Možete imati najlepši korisnički interfejs na svetu, najpametniji algoritam za preporuku proizvoda i najbrži proces registracije, ali ako aplikacija baca grešku 503 Service Unavailable u trenutku kada korisnik želi da plati račun, sve te funkcionalnosti vrede tačno nula dinara.
Agile koji ignoriše pouzdanost ne stvara poslovnu vrednost. On samo ubrzava gomilanje tehničkog duga i operativnog haosa. U takvom okruženju, svaki novi sprint čini sistem krhkijim, dok jednog dana ceo tim ne stane jer 80% vremena troši na krpljenje rupa u produkciji. Upravo tu SRE ulazi u priču, ne kao kočničar koji kaže „ne može“, već kao partner koji kaže „može, pod ovim merljivim uslovima“.
Tačka susreta: SLI, SLO i Error Budget kao zajednički jezik biznisa i inženjeringa
Najveći doprinos koji Site Reliability Engineering donosi Agile timovima jeste ukidanje subjektivnih svađa. U klasičnim organizacijama, razgovor između Product Owner-a i šefa infrastrukture izgleda kao pijaca: jedan traži da nova verzija ide odmah jer je tržište čeka, drugi tvrdi da sistem nije spreman i da je rizik prevelik. Odluku na kraju donosi onaj ko ima jaču političku poziciju u firmi ili ko glasnije viče na sastanku.
SRE ovaj problem rešava uvođenjem tri povezana koncepta koji prevode tehničke parametre na jezik biznisa:
-
SLI (Service Level Indicator – pokazatelj nivoa usluge): Ovo je konkretna, precizna metrika koja meri neki aspekt ponašanja sistema iz ugla korisnika. Na primer, to može biti procenat HTTP zahteva koji su uspešno obrađeni bez greške, ili vreme odziva (latency) za 99. percentil zahteva (p99) koje mora biti ispod 250 milisekundi.
-
SLO (Service Level Objective – ciljani nivo usluge): Ovo je ciljna vrednost koju sistem treba da ostvari za određeni SLI u zadatom vremenskom periodu. Na primer, cilj može biti da 99,9% svih zahteva za plaćanje u toku jednog meseca bude uspešno završeno u roku kraćem od 300 milisekundi.
-
SLA (Service Level Agreement – ugovor o nivou usluge): Ovo je formalni, pravni ili komercijalni ugovor sa klijentima koji definiše šta se dešava ako sistem padne ispod dogovorenog nivoa (obično povraćaj dela novca ili penali). U praksi, interni SLO je uvek stroži od eksternog SLA ugovora, kako bi tim imao prostor za reakciju pre nego što kompanija počne da plaća penale.
Iz razlike između 100% savršenstva i dogovorenog SLO cilja rađa se najgenijalniji alat modernog inženjerstva: Error Budget (budžet grešaka).
Zamislimo e-commerce platformu za koju su se menadžment, Product Owner i inženjeri zajedno dogovorili da je ciljana dostupnost (SLO) 99,9% na mesečnom nivou. Zašto ne 100%? Zato što je 100% dostupnosti u distribuiranim sistemima ekonomski besmislen cilj – svaki dodatni „devet“ u procentu dostupnosti višestruko povećava troškove infrastrukture, dok korisnici na svojim mobilnim mrežama razliku između 99,9% i 99,999% verovatno neće ni primetiti.
Ako je naš cilj 99,9% dostupnosti u mesecu koji ima 30 dana (43.200 minuta), to znači da naš sistem ima dozvoljeni budžet grešaka od 0,1%, odnosno tačno 43,2 minuta mesečno tokom kojih sme da bude nedostupan ili da vraća greške.
Taj budžet od 43,2 minuta pripada Agile timu da ga svesno „potroši“ na inovacije, eksperimente i brze isporuke novog koda. Pravila igre su kristalno jasna i unapred dogovorena:
-
Dok u budžetu ima preostalih minuta: Agile tim ima potpuno zeleno svetlo da izbacuje nove verzije u produkciju onoliko brzo koliko želi. Niko iz operativnog tima nema pravo da ih blokira.
-
Onog trenutka kada se budžet potroši (na primer, dva loša deployment-a su već pojela svih 43 minuta grešaka pre kraja meseca): automatski se zamrzava izbacivanje novih funkcionalnosti. Svi naredni sprintovi ili zadaci fokusiraju se isključivo na stabilnost, pisanje testova, popravku arhitekture i smanjenje rizika, sve dok se budžet kroz stabilan rad ponovo ne oporavi.
Ovo je trenutak u kojem SRE i Agile postaju jedan organizam. Product Owner više ne vidi pouzdanost kao apstraktnu prepreku, jer direktno vidi kako nestabilan kod „jede“ njegov budžet za nove funkcionalnosti. Sa druge strane, SRE inženjeri više ne glume policajce, već postaju savetnici koji pomažu programerima da bezbednije troše svoj budžet kroz postepene isporuke (canary releases) i automatizovane provere.
Eliminacija Toil-a: zašto inženjeri ne smeju biti ljudski roboti
U mnogim Agile timovima koji rade po Scrum ili Kanban okviru postoji hroničan problem nevidljivog posla. Na papiru tim ima kapacitet od 100 story poena, ali u stvarnosti završi jedva 60. Gde je nestalo ostalih 40%?
Nestalo je u onome što SRE naziva Toil (repetitivni, manuelni operativni rad). Toil je svaki posao vezan za održavanje produkcionog servisa koji je manuelan, ponavlja se iz nedelje u nedelju, može da se automatizuje, nema trajnu inženjersku vrednost i raste linearno sa rastom samog sistema.
Klasični primeri Toil-a su ručno pokretanje skripti za deployment, ručno čišćenje diskova na serverima kada se napune logovima, ručno kreiranje korisničkih naloga ili odgovaranje na stotine lažnih alarma (alert fatigue) koji stižu usred noći, a ne zahtevaju nikakvu stvarnu akciju.
Ako dozvolite da inženjeri većinu vremena provode u ovakvom radu, dešavaju se dve katastrofalne stvari: najbolji ljudi vam daju otkaz jer ne žele da budu ljudski roboti, a sistem ne napreduje jer niko nema vremena da reši uzrok problema.
Zato Google-ov SRE model postavlja strogo ograničenje: najviše 50% vremena SRE inženjera sme da ode na operativni rad i rešavanje incidenata, dok najmanje 50% vremena mora biti posvećeno čistom inženjerskom radu – pisanju koda, izgradnji alata za automatizaciju i unapređenju arhitekture.
Kada se ovo pravilo prenese u Agile okruženje, ono menja način na koji se planira sprint. Kapacitet za automatizaciju i smanjenje Toil-a više se ne tretira kao „luksuz ako ostane vremena u petak“, već kao prvorazredni zadatak u backlog-u sa jasnom poslovnom vrednošću. Svaki sat uložen u automatizaciju jednog zamornog procesa vraća se timu desetostruko u narednim mesecima kroz brže i bezbednije sprintove.
DORA metrike i mit o lažnom izboru između brzine i stabilnosti
Godinama je u menadžmentu vladala dogma da morate da birate: ili ćete isporučivati softver brzo i prihvatiti da će često pucati, ili ćete isporučivati sporo i oprezno da biste imali stabilan sistem.
Višegodišnja istraživanja koja sprovodi DORA (DevOps Research and Assessment) na uzorku od desetina hiljada inženjera i kompanija širom sveta u potpunosti su razbila ovaj mit. Podaci dosledno pokazuju da brzina i stabilnost nisu suprotstavljene sile, već da se međusobno pojačavaju.
DORA definiše četiri ključne metrike koje savršeno povezuju Agile efikasnost i SRE pouzdanost:
-
Deployment Frequency (učestalost isporuke): Koliko često organizacija uspešno izbacuje kod u produkciju.
-
Lead Time for Changes (vreme od ideje do produkcije): Koliko vremena prođe od trenutka kada je kod napisan (commit) do trenutka kada se on izvršava pred korisnicima.
-
Change Failure Rate (stopa neuspešnih promena): Koliki procenat isporuka u produkciju izazove incident, pad sistema ili zahteva hitnu intervenciju (hotfix/rollback).
-
Time to Restore Service (vreme oporavka usluge – MTTR): Koliko vremena je potrebno timu da vrati sistem u normalno stanje kada do incidenta ipak dođe.
Prve dve metrike mere Agile agilnost i brzinu isporuke poslovne vrednosti. Druge dve mere SRE pouzdanost i otpornost sistema.
Ono što DORA izveštaji iz godine u godinu dokazuju jeste da elitni timovi (Elite Performers) ne žrtvuju jedno zarad drugog. Oni izbacuju kod u produkciju više puta dnevno (visok Deployment Frequency) sa vremenom isporuke manjim od jednog sata (kratak Lead Time), dok im istovremeno manje od 5% promena izaziva bilo kakav problem (nizak Change Failure Rate), a kada se problem desi, oporavljaju sistem za nekoliko minuta (nizak MTTR).
Zašto je to tako? Zato što male, česte promene nose neuporedivo manji rizik od velikih, tromih isporuka jednom u tri meseca. Kada u produkciju pošaljete 50 linija koda i nešto krene po zlu, odmah znate gde je greška i vraćate sistem unazad za trideset sekundi. Kada pošaljete 50.000 linija koda odjednom, traženje uzroka pada pretvara se u višednevnu forenziku.
Blameless Postmortem i psihološka sigurnost: kako Agile retrospektiva dobija zube
Svaki Agile tim poznaje ceremoniju retrospektive na kraju sprinta, gde se razgovara o tome šta je bilo dobro, a šta može bolje. Nažalost, u mnogim firmama retrospektive se vremenom pretvore u formalnost ili, još gore, u traženje krivca kada nešto pođe po zlu.
SRE donosi daleko zreliji i operativno korisniji mehanizam: Blameless Postmortem (analiza incidenta bez traženja krivca).
Osnovna pretpostavka ovog pristupa glasi: ljudska greška nikada nije korenski uzrok incidenta, već simptom loše dizajniranog sistema. Ako je junior programer u petak popodne jednim pogrešnim klikom obrisao produkcionu bazu podataka, problem nije u tom programeru. Problem je u sistemu koji je uopšte dozvolio da pojedinac bez dvostruke potvrde, provere dozvola i automatskog backup-a ima pristup komandi koja može da uništi produkciju.
Kada u kompaniji vlada kultura kažnjavanja, inženjeri počinju da kriju greške, usporavaju rad iz straha i troše energiju na pisanje mejlova kojima se ograđuju od odgovornosti. Kada uvedete Blameless Postmortem, cilj sastanka nakon pada sistema je isključivo rekonstrukcija hronologije događaja, razumevanje zašto su postojeći kontrolni mehanizmi zakazali i definisanje konkretnih tehničkih zadataka koji će sprečiti da se ista greška ikada ponovi. Ti zadaci zatim ulaze direktno u naredni Agile sprint kao prioritetne stavke.
Ovakav pristup gradi istinsku psihološku sigurnost u timu, što je i Google-ovo interno istraživanje (Project Aristotle) izdvojilo kao najvažniji faktor za uspeh svakog visokoproduktivnog tima.
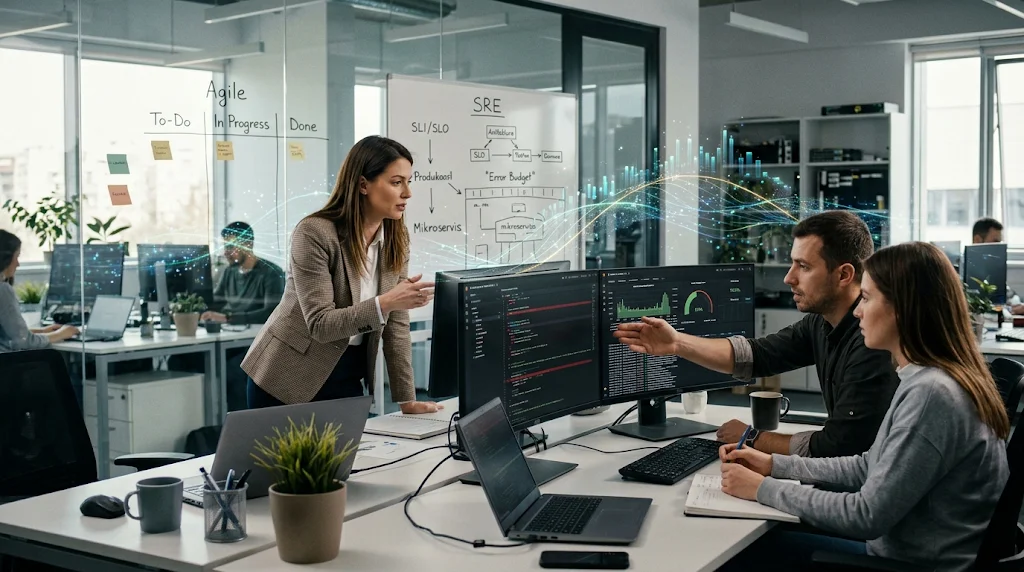
Praktičan primer iz realnog sveta: kako izgleda sprint kada SRE sedi za istim stolom
Da bismo ovu teoriju spustili na zemlju, pogledajmo kako izgleda konkretan dvonedeljni sprint u timu koji razvija finansijsku aplikaciju za instant plaćanja i koji je uspešno spojio Agile i SRE principe.
1. Sprint Planning i Refinement (definisanje posla):
Tim planira uvođenje novog algoritma za detekciju prevara tokom transakcije. U klasičnom Agile timu, priča bi se završila opisom poslovne logike. Ovde, međutim, SRE inženjer učestvuje u planiranju i u Definition of Done (definiciju završenog posla) dodaje jasne operativne kriterijume: novi servis ne sme da doda više od 40 milisekundi kašnjenja (latency) na ukupno vreme transakcije, mora imati definisane metrike za Prometheus/Grafana nadzor, i mora imati ugrađen Circuit Breaker (automatski prekidač) koji će ga isključiti ako počne da usporava sistem, kako korisnici ne bi ostali blokirani.
2. Razvoj i Continuous Integration (tokom sprinta):
Programeri pišu kod, ali paralelno sa poslovnom logikom pišu i sintetičke testove opterećenja. Svaki Pull Request automatski prolazi kroz bezbednosne i performanse provere pre spajanja u glavnu granu.
3. Progressive Delivery (isporuka bez stresa):
Umesto da novu verziju puste svim korisnicima odjednom, tim koristi kombinaciju Feature Flags (prekidača funkcionalnosti) i Canary Deployment-a (postepene isporuke). Novi kod se prvo pušta na samo 1% saobraćaja. Automatizovani SRE alati u realnom vremenu prate SLO metrike (stopu grešaka i vreme odziva). Ako se u prvih 15 minuta potrošnja Error Budget-a naglo poveća, sistem automatski radi rollback i vraća saobraćaj na staru verziju, dok programer dobija precizan izveštaj šta se desilo. Ako sve prođe glatko, saobraćaj se postepeno podiže na 10%, 50% i konačno 100%.
4. Chaos Engineering (proaktivno testiranje otpornosti):
Jednom mesečno, u kontrolisanim uslovima, tim namerno ubacuje kvar u sistem – na primer, simulira pad jedne baze podataka ili naglo usporavanje eksternog bankarskog API-ja – kako bi proverio da li sistem zaista preživljava onako kako je projektovano na papiru.
Rezultat ovakvog rada je merljiv na svim nivoima: Product Owner dobija brzu isporuku novih funkcionalnosti, inženjeri mirno spavaju vikendom jer sistem sam štiti sebe, a kompanija gradi reputaciju servisa koji nikada ne pada.
Gde kompanije najčešće greše pri uvođenju SRE praksi u Agile okruženje?
Iako na papiru sve zvuči logično, u praksi mnoge organizacije sapliću se o iste zamke kada pokušaju da spoje ove dva sveta:
-
Stvaranje novog silosa („SRE tim kao čistač“): Najgora moguća implementacija jeste kada kompanija formira poseban SRE tim i kaže programerima: „Vi samo pišite kod što brže, a SRE će to da održava i popravlja u produkciji.“ Time ste samo napravili novi zid, identičan onom koji je postojao pre dvadeset godina. SRE principi moraju biti deo svakodnevnog rada razvojnih timova, a SRE inženjeri treba da rade kao konsultanti i graditelji platforme, a ne kao nečije dadilje.
-
Preterano inženjerstvo pouzdanosti (99,999% po svaku cenu): Mnogi timovi iz sujete postavljaju nerealno visoke SLO ciljeve. Održavanje pet devetki dostupnosti (manje od 5 minuta pada godišnje) zahteva ogromne investicije u multi-region arhitekturu, replikaciju podataka u realnom vremenu i 24/7 dežurstva. Ako pravite internu aplikaciju za naručivanje kancelarijskog materijala ili portal za lokalne vesti, takav nivo pouzdanosti je čisto bacanje novca koje direktno ubija agilnost.
-
Zaboravljanje poslovnog konteksta: Tehničke metrike poput opterećenja procesora (CPU usage) ili zauzeća memorije nisu dovoljne. Ako je procesor na 95%, ali korisnici i dalje bez ikakvog zastoja završavaju kupovinu, vi nemate incident. Sa druge strane, ako su svi serveri zeleni, a korisnici ne mogu da se uloguju zbog isteka SSL sertifikata, vi imate ozbiljan poslovni problem. Fokus uvek mora biti na iskustvu krajnjeg korisnika.
O važnosti usklađivanja tehnoloških procesa sa realnim poslovnim ciljevima i automatizacijom procesa bez nepotrebnog komplikovanja često pišemo i na portalu Joombooz, gde se jasno vidi da svaka tehnologija ima smisla isključivo onoliko koliko direktno doprinosi efikasnosti poslovanja i zadovoljstvu kupaca.
Budućnost SRE-a i Agile-a (2026-2030): AI agenti, Platform Engineering i autonomna pouzdanost
Dok ulazimo u završnicu 2026. godine i gledamo ka periodu do 2030, pravila igre u softverskom inženjerstvu menjaju se brže nego ikada ranije. Masovna upotreba generativne veštačke inteligencije i autonomnih AI agenata za pisanje koda dovela je do eksplozije količine softvera koji se svakodnevno proizvodi.
Kao što smo već analizirali na portalu ITNetwork u tekstovima o AI-native Software Development-u i AI Code Review-u, brzina pisanja koda više nije usko grlo. Kada AI agenti mogu da generišu hiljade linija koda za nekoliko minuta, glavno usko grlo postaju verifikacija, bezbednost i pouzdanost u produkciji.
U takvom okruženju, spoj Agile-a i SRE-a evoluira u tri jasna pravca:
-
Platform Engineering i Internal Developer Platforms (IDP): Umesto da svaki Agile tim sam brine o Kubernetes konfiguracijama, alatima za nadzor i bezbednosnim polisama, SRE i platformski timovi grade interne samouslužne platforme. Programer dobija „zlatnu stazu“ (Golden Path) – jednim klikom pokreće novi mikroservis koji već ima ugrađene SLO metrike, automatsko skaliranje i CI/CD cevovod. Agilnost raste jer su najbolje SRE prakse zapakovane kao gotov proizvod.
-
AIOps i autonomni oporavak sistema (Self-Healing Infrastructure): Sa rastom kompleksnosti mikroservisa, ljudi više ne mogu ručno da povežu hiljade logova i metrika u trenutku incidenta. AI modeli trenirani na istorijskim podacima o incidentima već sada preuzimaju trijažu alarma, otkrivaju korelacije između naizgled nepovezanih servisa i pokreću automatske korektivne akcije (npr. preusmeravanje saobraćaja ili izolaciju problematičnog čvora) pre nego što Error Budget uopšte počne ozbiljnije da se topi.
-
Verifikacija pouzdanosti kao sastavni deo AI razvojnog ciklusa: Budući Agile sprintovi neće meriti uspeh brojem napisanih linija koda, već sposobnošću sistema da sam dokaže svoju otpornost. Svaki kod koji generiše čovek ili AI agent moraće da prođe kroz automatizovane simulacije opterećenja i provere usklađenosti sa arhitektonskim pravilima pre nego što dobije dozvolu za ulazak u produkciju.
Zaključak: Pouzdanost je najvažnija funkcionalnost svakog proizvoda
Decenijska podela na one koji „grade proizvod“ i one koji „čuvaju servere“ postala je poslovno neodrživa. U modernoj digitalnoj ekonomiji, gde korisnik jednim klikom prelazi kod konkurencije čim aplikacija zatrokira, pouzdanost više nije tehnički detalj u nadležnosti IT odeljenja – ona je temelj brenda, poverenja i prihoda.
Agile nam je dao okvir za brzo učenje, prilagođavanje tržištu i kontinuiranu isporuku vrednosti. Site Reliability Engineering nam je dao inženjersku disciplinu, merljive ciljeve i alate koji garantuju da ta vrednost neće nestati pod prvim ozbiljnijim naletom korisnika.
Kada ove dve filozofije prestanu da se posmatraju kao suparnici i spoje se kroz zajedničke ciljeve (SLO), budžet grešaka (Error Budget) i kulturu učenja bez traženja krivca, kompanija dobija najjaču moguću konkurentsku prednost: sposobnost da se menja brzinom startapa, a da pritom ostane stabilna poput bankarskog trezora. A to je jedina formula koja na duge staze pobeđuje na tržištu.
Često postavljana pitanja (FAQ)
Šta je Site Reliability Engineering (SRE)?
Site Reliability Engineering je inženjerska disciplina nastala u kompaniji Google koja primenjuje principe i prakse softverskog inženjerstva na probleme infrastrukture i operativnog rada. Glavni cilj SRE-a je izgradnja skalabilnih i visoko pouzdanih softverskih sistema kroz automatizaciju i merljive pokazatelje.
Koja je razlika između DevOps-a i SRE-a?
DevOps je šira organizaciona kultura i skup principa koji promovišu saradnju između razvojnih i operativnih timova radi brže isporuke softvera. SRE je konkretna, tehnička implementacija tih principa sa jasno definisanim metrikama (SLI, SLO), budžetom grešaka i pravilima za eliminaciju manuelnog rada.
Kako SRE i Agile funkcionišu zajedno u praksi?
Agile se fokusira na brzu, iterativnu isporuku novih funkcionalnosti i poslovne vrednosti, dok SRE obezbeđuje da te funkcionalnosti rade stabilno i pouzdano u produkciji. Njihov glavni spoj je Error Budget (budžet grešaka), koji timovima daje jasnu meru koliko rizika smeju da preuzmu pri izbacivanju novog koda.
Šta su SLI, SLO i SLA?
SLI (Service Level Indicator) je konkretna metrika koja meri ponašanje sistema (npr. brzina odziva ili procenat uspešnih zahteva). SLO (Service Level Objective) je ciljna vrednost koju sistem treba da postigne za tu metriku (npr. 99,9% dostupnosti mesečno). SLA (Service Level Agreement) je pravni ugovor sa klijentima koji definiše posledice i penale ako sistem padne ispod dogovorenog nivoa.
Šta je Error Budget (budžet grešaka) i zašto je važan za biznis?
Error Budget je dozvoljena količina nestabilnosti ili zastoja sistema u određenom periodu (npr. 0,1% ili oko 43 minuta mesečno kod SLO-a od 99,9%). On omogućava timu da bez straha izbacuje nove funkcionalnosti sve dok ne potroši budžet, čime se eliminišu subjektivne rasprave između menadžmenta i inženjera.
Šta znači pojam Toil u SRE metodologiji?
Toil predstavlja repetitivni, manuelni operativni rad vezan za održavanje servisa koji ne donosi trajnu inženjersku vrednost i može da se automatizuje (npr. ručni deployment ili ručno restartovanje servisa). Prema Google-ovom pravilu, SRE inženjeri ne bi smeli da troše više od 50% vremena na Toil.
Da li svaka kompanija treba da cilja 99,999% dostupnosti sistema?
Ne. Postizanje „pet devetki“ dostupnosti (manje od 5,26 minuta zastoja godišnje) je izuzetno skupo i tehnički kompleksno. Ciljani nivo pouzdanosti (SLO) uvek treba da bude usklađen sa realnim potrebama korisnika i poslovnom logikom proizvoda.
Šta su DORA metrike?
DORA metrike su četiri ključna pokazatelja performansi softverskih timova koje je definisao tim DevOps Research and Assessment: učestalost isporuke (Deployment Frequency), vreme od promene do produkcije (Lead Time for Changes), stopa neuspešnih promena (Change Failure Rate) i vreme oporavka usluge (MTTR).
Šta je Blameless Postmortem?
Blameless Postmortem je strukturisana analiza nakon produkcionog incidenta čiji cilj nije pronalaženje i kažnjavanje pojedinca koji je napravio grešku, već otkrivanje sistemskih i procesnih propusta koji su omogućili da do greške dođe i njeno trajno otklanjanje.
Kako će veštačka inteligencija (AI) uticati na SRE i Agile u narednim godinama?
Kako AI agenti drastično ubrzavaju pisanje koda, SRE prakse postaju još važnije za verifikaciju stabilnosti i bezbednosti pre ulaska koda u produkciju. Istovremeno, AI alati (AIOps) sve više preuzimaju analizu logova, predviđanje kvarova i automatski oporavak infrastrukture bez ljudske intervencije.