
Organizacija koja razvija matematičke referentne tačke za AI nije otkrila da je primila finansijsku podršku od OpenAI-a sve do nedavno, što je izazvalo optužbe za nepravilnosti od strane nekih u AI zajednici.
Epoch AI, neprofitna organizacija koja je uglavnom finansirana od strane Open Philanthropy, istraživačke i donatorske fondacije, objavila je 20. decembra da je OpenAI podržao kreiranje FrontierMath-a. FrontierMath, test sa problemima na stručnom nivou dizajniran da meri matematičke veštine AI-a, bio je jedan od referentnih tačaka koje je OpenAI koristio za demonstraciju svog predstojećeg vodećeg AI modela, o3.
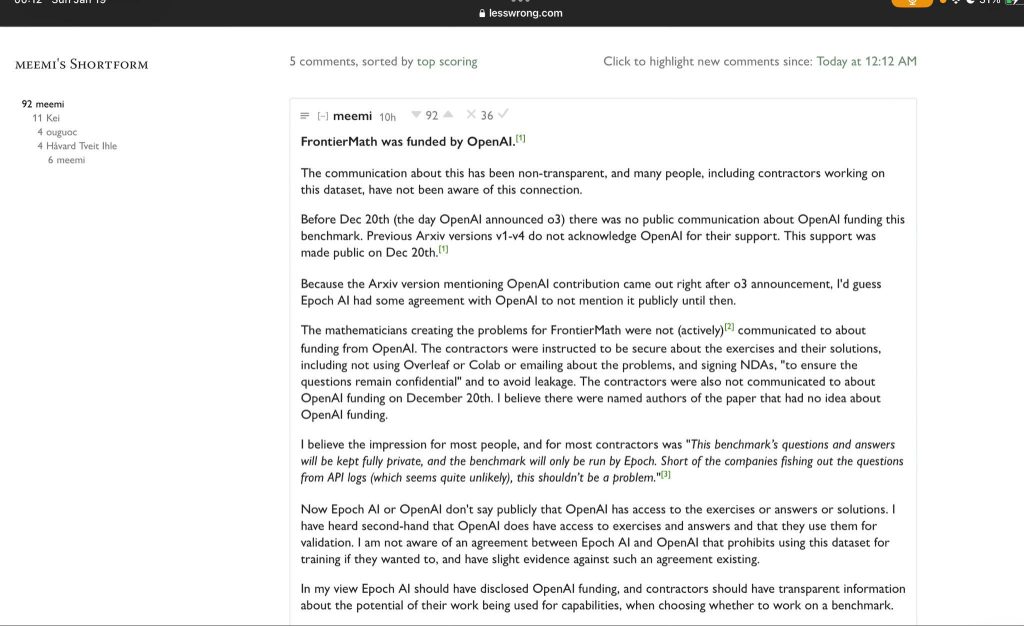
U postu na forumu LessWrong, ugovorni radnik za Epoch AI koji koristi korisničko ime „Meemi“ rekao je da mnogi doprinosioci FrontierMath referentne tačke nisu bili obavešteni o uključenosti OpenAI-a sve dok to nije postalo javno.
„Komunikacija u vezi s tim nije bila transparentna“, napisao je Meemi. „Po mom mišljenju, Epoch AI je trebalo da otkrije finansiranje od strane OpenAI-a, a ugovorni radnici bi trebalo da imaju transparentne informacije o potencijalu njihovog rada koji se koristi za sposobnosti, kada biraju da rade na referentnoj tački.“
Na društvenim mrežama, neki korisnici su izrazili zabrinutost da bi tajnost mogla da naruši reputaciju FrontierMath-a kao objektivne referentne tačke. Pored finansijske podrške za FrontierMath, OpenAI je imao uvid u mnoge od problema i rešenja u referentnoj tački — činjenicu koju Epoch AI nije otkrio pre 20. decembra, kada je najavljen o3.
U postu na X, studentkinja matematike sa Stanforda, Carina Hong, takođe je optužila OpenAI za privilegovani pristup FrontierMath-u zahvaljujući aranžmanu sa Epoch AI, što nije dobro prihvaćeno od strane nekih doprinosaoca.
„Šest matematičara koji su značajno doprinosili FrontierMath referentnoj tački potvrdili su [meni]… da nisu znali da će OpenAI imati ekskluzivni pristup ovoj referentnoj tački (a drugi neće),“ rekla je Hong. „Većina izražava da nisu sigurni da bi doprineli da su znali.“
U odgovoru na post Meemi-a, Tamay Besiroglu, zamenik direktora Epoch AI i jedan od suosnivača organizacije, tvrdio je da integritet FrontierMath-a nije bio ugrožen, ali je priznao da je Epoch AI „napravio grešku“ u vezi sa nedovoljnom transparentnošću.
„Bili smo ograničeni u otkrivanju partnerstva do otprilike trenutka kada je o3 lansiran, a unazad bismo trebali više pregovarati da bismo imali mogućnost da budemo transparentni sa doprinosiocima referentne tačke što je pre moguće“, napisao je Besiroglu. „Naši matematičari su zaslužili da znaju ko bi mogao da ima pristup njihovom radu. Iako smo bili ugovorno ograničeni u onome što smo mogli reći, trebalo je da transparentnost sa našim doprinosiocima bude neodustajanje u našem dogovoru sa OpenAI.“
Besiroglu je dodao da, iako OpenAI ima pristup FrontierMath-u, postoji „verbalni dogovor“ između OpenAI i Epoch AI da ne koristi problem set FrontierMath-a za obuku svog AI-a. (Obučavanje AI-a na FrontierMath-u bilo bi slično učenju za test.) Epoch AI takođe ima „poseban set za zadržavanje“ koji služi kao dodatna zaštita za nezavisnu verifikaciju rezultata FrontierMath referentne tačke, rekao je Besiroglu.
„OpenAI je… potpuno podržao našu odluku da zadržimo odvojeni, neviđeni set podataka“, napisao je Besiroglu.
Međutim, situaciju dodatno komplikuje izjava glavnog matematičara Epoch AI, Ellota Glazera, koji je u postu na Redditu napomenuo da Epoch AI nije u mogućnosti nezavisno da verifikuje rezultate FrontierMath-a koje je OpenAI postigao sa o3.
„Moje lično mišljenje je da je [OpenAI-ov] rezultat legitiman (tj. nisu trenirali na tom skupu podataka) i da nemaju motiv da lažu o internim rezultatima benchmark testiranja“, rekao je Glazer. „Međutim, ne možemo ih potvrditi dok naša nezavisna evaluacija ne bude završena.“
Ova saga je još jedan primer izazova u razvoju empirijskih referentnih tačaka za evaluaciju AI-a — i obezbeđivanje neophodnih resursa za razvoj tih referentnih tačaka bez stvaranja percepcije sukoba interesa.


