
Kada čovek pogleda fotografiju psa u parku, njegov mozak u deliću sekunde prepoznaje životinju, rasu, boju dlake, položaj tela, pa čak i njeno raspoloženje. Za ljudski vizuelni korteks ovaj proces deluje potpuno prirodno i ne zahteva svestan napor. Međutim, za računar je ista ta slika na samom početku samo beživotna, haotična gomila brojeva.
Kako onda mašina uspeva da premosti jaz između sirovog digitalnog zapisa i stvarnog razumevanja onoga što se nalazi u kadru? Odgovor leži u kompjuterskom vidu (Computer Vision), jednoj od najdinamičnijih oblasti veštačke inteligencije. Ova tehnologija omogućava softveru ne samo da registruje sliku, već da je raščlani, interpretira i donese konkretne odluke na osnovu vizuelnog sadržaja.
Šta računar zapravo vidi: iluzija slike i matrica brojeva
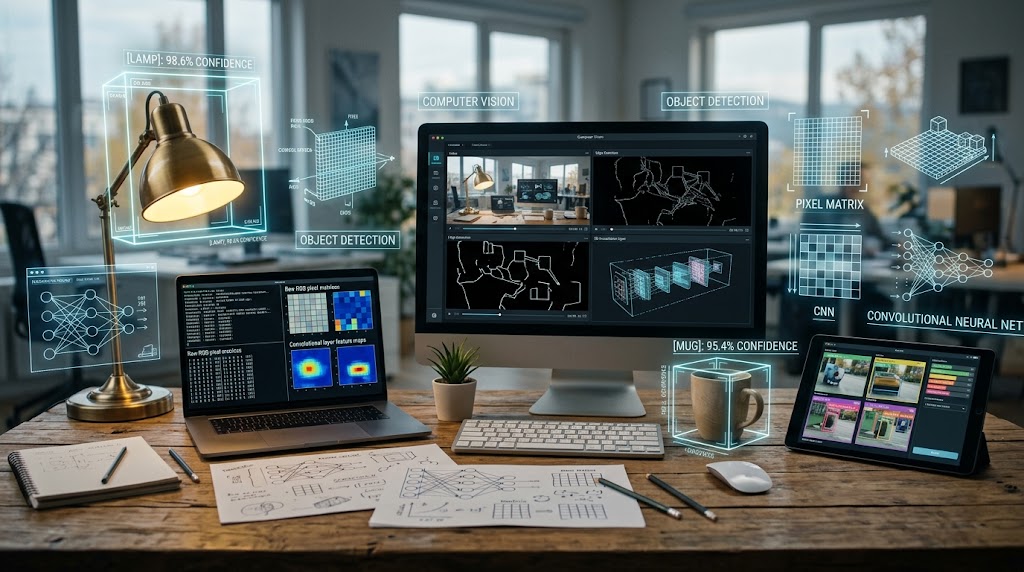
Za razliku od ljudskog oka koje reaguje na svetlost i fotone, računar ne vidi oblike, boje niti teksture. Svaka digitalna slika je zapravo dvodimenzionalna ili trodimenzionalna mreža piksela, organizovana u matematičku matricu.
Kada računar otvori standardnu kolor fotografiju, on je posmatra kroz tri kanala boja – crveni, zeleni i plavi (RGB):
-
Svaki piksel ima dodeljenu brojčanu vrednost u rasponu od 0 do 255, gde 0 označava potpuno odsustvo boje (crno), a 255 maksimalni intenzitet svetlosti;
-
Slika standardne rezolucije od 1920×1080 piksela sadrži preko dva miliona pojedinačnih tačaka, a svaka od njih ima tri različite vrednosti za boju;
-
Računar u prvom koraku vidi tabelu sa više od šest miliona brojeva, bez ikakve naznake šta ti brojevi zajedno predstavljaju.
Zadatak algoritama kompjuterskog vida jeste da u tom moru cifara pronađu statističke pravilnosti, prepoznaju prelaze i povežu tačke u smislene celine.
 Hijerarhija učenja: kako konvolucione neuronske mreže grade sliku
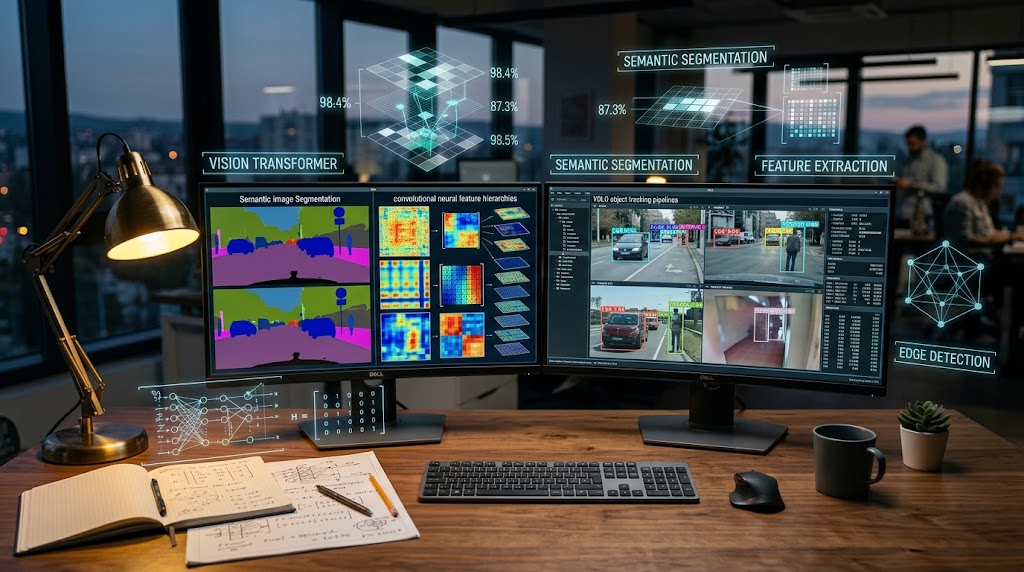
Ključni tehnološki preokret u prepoznavanju slika desio se razvojem konvolucionih neuronskih mreža (Convolutional Neural Networks – CNN). Ove mreže funkcionišu po principu hijerarhijskog prepoznavanja oblika, slično načinu na koji ljudski mozak obrađuje vizuelne stimuluse.
Proces analize odvija se kroz nekoliko uzastopnih slojeva:
1. Početni slojevi: detekcija ivica i prelaza
Prvi slojevi mreže ne pokušavaju da prepoznaju ceo objekat. Oni prelaze preko slike malim matematičkim filterima (jezgrima) i traže jednostavne promene u intenzitetu piksela. Na ovom nivou model uočava samo horizontalne, vertikalne i dijagonalne linije, uglove i oštre kontraste svetla i senke.
2. Srednji slojevi: sklapanje geometrijskih oblika i tekstura
Informacije iz prvih slojeva se sabiraju i prenose u sledeću fazu. Mreža počinje da sklapa prepoznate ivice u složenije strukture: krugove, kvadrate, paralelne linije, teksturu krzna, mrežu prozora ili sjaj metala.
3. Duboki slojevi: formiranje delova objekata
Kako se podaci kreću dublje kroz neuronsku mrežu, apstrakcija raste. Model kombinuje geometrijske oblike i prepoznaje specifične delove tela ili predmeta: točak automobila, pseće uvo, far na vozilu ili ručku na vratima.
4. Završni sloj: donošenje konačne odluke (Klasifikacija)
Na samom kraju, potpuno povezani sloj mreže analizira prisustvo svih izdvojenih elemenata. Ako model na slici detektuje specifičnu kombinaciju njuške, repa, krzna i četiri šape, on zaključuje sa verovatnoćom od 98% da se na fotografiji nalazi pas.
Tri nivoa vizuelnog prepoznavanja: klasifikacija, detekcija i segmentacija
U zavisnosti od zadatka koji softver treba da reši, kompjuterski vid primenjuje različite nivoe analize:
-
Klasifikacija slike (Image Classification): Najjednostavniji zadatak gde softver odgovara na pitanje: „Šta se nalazi na ovoj slici u celini?“ (npr. fotografija prikazuje kamion);
-
Detekcija objekata (Object Detection): Model ne samo da imenuje objekte, već određuje i njihove tačne koordinate crtanjem pravougaonika oko njih (Bounding Box). Algoritmi poput YOLO (You Only Look Once) omogućavaju da sistem u realnom vremenu detektuje više različitih automobila, pešaka i saobraćajnih znakova na istom video snimku;
-
Semantička i instancna segmentacija (Image Segmentation): Najprecizniji nivo gde računar obeležava svaki pojedinačni piksel koji pripada određenom objektu. Umesto grubog pravougaonika, softver ocrtava tačne ivice pešaka ili ivicu kolovoza, što je kritično za autonomna vozila i medicinsku dijagnostiku.
Vision Transformers: nova paradigma koja posmatra celu scenu
Iako su konvolucione mreže decenijama bile neprikosnovene, pojava vizuelnih transformera (Vision Transformers – ViT) donela je revoluciju u načinu na koji mašine analiziraju slike.
Umesto da sliku skeniraju piksel po piksel kroz lokalne filtere, transformeri seku sliku na veće celine (vizuelne pečate ili tokene) i posmatraju ih istovremeno. Koristeći mehanizam samopažnje (Self-Attention), model analizira međuodnos svih delova scene odjednom. Na taj način transformer momentalno razume kontekst: da li se čaša nalazi na stolu ili u vazduhu, i kako osvetljenje u gornjem levom uglu utiče na senku u donjem desnom uglu.
Zašto je prepoznavanje slika i dalje izuzetno teško za mašine
Iako tehnologija beleži impresivne rezultate, računari se u stvarnom svetu suočavaju sa preprekama koje čovek rešava bez muke:
-
Promena osvetljenja i ugla posmatranja: Isti pas slikan na podnevnom suncu i u mračnoj sobi ima potpuno različite vrednosti piksela. Pas slikan odozgo izgleda drastično drugačije nego slikan s profila;
-
Delimično zaklanjanje (Okluzija): Ako se mačka sakrije iza zavese tako da joj se vidi samo rep, čovek zna da je zavesa sakrila ostatak mačke. Model bez dovoljno podataka može zaključiti da je rep zapravo zmija ili komad užeta;
-
Sličnost pozadine i objekta: Kamuflaža u prirodi ili industrijski delovi iste boje kao radna traka zahtevaju napredne algoritme za izdvajanje kontura;
-
Zavisnost od konteksta: Ako model vidi viljušku u radionici među alatom, može je pogrešno klasifikovati kao metalni ključ jer je navikao da viljuške prepoznaje isključivo u kuhinjskom okruženju.
 Gde kompjuterski vid već menja industriju
Sposobnost mašina da vide i razumeju prostor oko sebe temelj je moderne automatizacije:
-
Medicina i radiologija: Algoritmi analiziraju rendgenske snimke, magnetne rezonance i skenere, prepoznajući rane faze tumora i mikroskopske prelome znatno pre nego što postanu uočljivi ljudskom oku;
-
Autonomna vožnja: Sistemi u vozilima Tesla ili Waymo neprekidno obrađuju video tokove sa desetina kamera, mere udaljenost objekata, prepoznaju trake na putu i predviđaju kretanje pešaka;
-
Industrijska kontrola kvaliteta: Kamere na proizvodnim trakama brzinom od stotinu komada u minuti uočavaju mikropukotine na metalnim delovima ili štamparske greške na ambalaži;
-
Maloprodaja i bezbednost: Pametne prodavnice bez kasa prepoznaju koje artikle kupac uzima sa police i automatski zadužuju njegov račun bez potrebe za skeniranjem barkodova.
Pogled u budućnost vizuelne inteligencije
Kompjuterski vid je prešao put od jednostavnih matematičkih filtera za linije do kompleksnih neuronskih mreža koje razumeju dinamiku fizičkog sveta. Spajanjem kompjuterskog vida sa velikim jezičkim modelima (multimodalni AI) dobijamo sisteme koji ne samo da vide šta se nalazi na slici, već mogu detaljno da opišu situaciju, objasne uzročno-posledične veze i odgovore na svako pitanje o posmatranom kadru. Mašine su konačno progledale, a način na koji obrađuju vizuelne podatke redefiniše granice digitalne industrije.