
Ključne teze (Key Takeaways) – šta je najbitnije u ovom tekstu
Najvažnija stvar koju treba razumeti jeste da DevOps nije „tim koji radi deploy“ i nije puki skup alata kao što su Jenkins, Docker, Kubernetes ili GitHub Actions.
DevOps je širi organizacioni i tehnički model kojim se uklanja istorijska barijera između inženjera koji razvijaju softver i timova koji treba da ga bezbedno, stabilno i kontinuirano isporučuju i održavaju u produkciji.
Zbog toga DevOps ima prirodnu, organsku vezu sa agilnim razvojem:
-
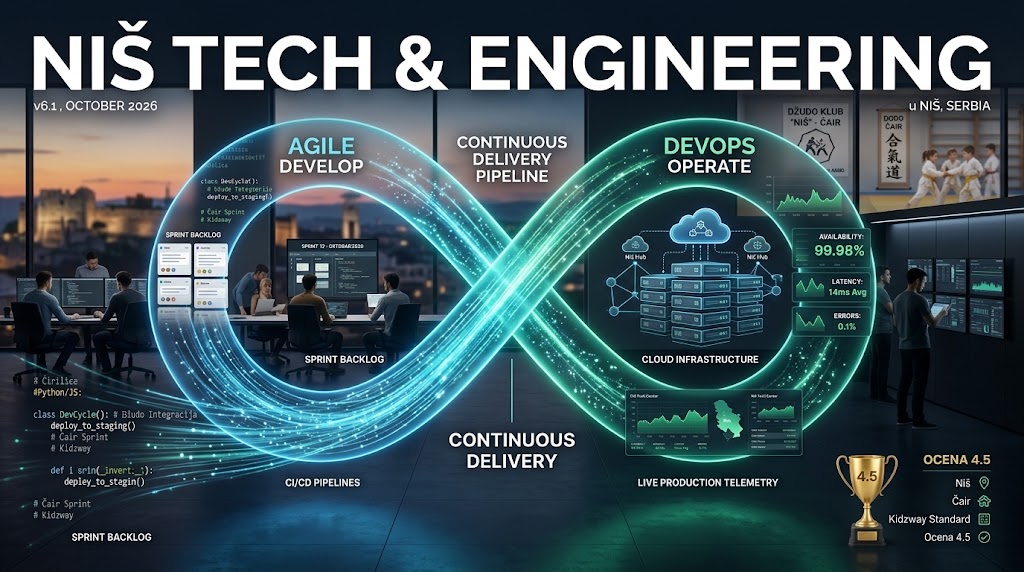
Agile je ubrzao petlju povratnih informacija (Feedback Loop) između ideje, razvojnog tima, proizvoda i krajnjeg korisnika.
-
DevOps tu istu petlju proširuje na inženjersku infrastrukturu: Build proces, automatsko testiranje, bezbednost (Security), konfiguraciju, Deployment, produkcionu stabilnost, opservabilnost (Observability) i upravljanje incidentima (Incident Response).
Bez ovog proširenja nastaje paradoks koji se svakodnevno viđa u velikim IT organizacijama: Development je agilan, ali je Delivery ostao Waterfall.
Tim radi u dvonedeljnim sprintovima, kod je spreman već petog dana, ali se na QA okruženje čeka tri dana, bezbednosna provera traje četiri, Odbor za odobrenje izmena (Change Advisory Board) zaseda tek sledećeg četvrtka, a termin za deployment u produkciju otvara se jednom mesečno. Kompanija nakon toga konstatuje: „Scrum nas nije dovoljno ubrzao.“ Problem, međutim, nije u Scrum-u. Problem je što se agilni proces završio tačno tamo gde počinje najsporiji deo sistema.
DORA (DevOps Research and Assessment) danas DevOps definiše kao organizacioni i kulturni pokret čiji je cilj povećanje brzine isporuke softvera, pouzdanosti servisa i zajedničkog vlasništva (Shared Ownership) među svim učesnicima u životnom ciklusu softvera. To prevazilazi puku automatizaciju deploymenta – zato DevOps i Agile treba posmatrati kao dve neodvojive faze jedne te iste evolucije.
 Agile je rešio jedan problem, ali je otkrio sledeći
Pre pojave agilnih metodologija, razvoj softvera pratio je kruti sekvencijalni model: meseci prikupljanja zahteva, meseci projektovanja, meseci programiranja, a zatim iscrpljujuća faza testiranja i jedna masivna isporuka na kraju.
Problem je bio očigledan: korisnik je softver video prekasno. Ako je poslovni problem bio pogrešno shvaćen, to bi se otkrilo tek nakon što je potrošen ogroman deo budžeta.
Agilni pristup je doneo promenu:
-
rad u malim paketima (Small Batches),
-
rano prikupljanje povratnih informacija,
-
fleksibilno prilagođavanje prioriteta.
Međutim, ubrzo se otvorilo novo pitanje: šta vredi što inženjerski tim kreira funkcionalan softverski inkrement svake dve nedelje, ako organizacija tehnički ne može da ga isporuči korisniku češće od jednom u tri meseca?
Ako je proces isporuke ostao spor, ručan i rizičan, agilnost u pisanju koda gubi poslovni smisao. Na toj tački počinje DevOps.
DevOps je nastao na granici između „radi kod mene“ i „radi u produkciji“
Tradicionalni IT inženjering decenijama je funkcionisao iza visokog organizacionog zida:
-
Razvojni tim (Development): „Mi smo napisali kod i na našim mašinama sve radi.“
-
Operativni tim (Operations): „Sada mi moramo da održavamo taj sistem u životu.“
Interesi ove dve strane bili su postavljeni konfliktno. Programeri su nagrađivani za promene, brzinu i nove funkcionalnosti. Operativci su procenjivani na osnovu stabilnosti, dostupnosti (uptime) i odsustva incidenata. Za Operations, svaka nova promena koda predstavljala je potencijalnu pretnju stabilnosti produkcije.
DevOps rešava ovaj konflikt promenom arhitekture sistema. Umesto traženja krivca za padove, fokus se pomera na pitanje: kako da promene učinimo dovoljno malim, automatizovanim, testiranim i merljivim, tako da ih možemo isporučivati svakodnevno bez destabilizacije sistema?
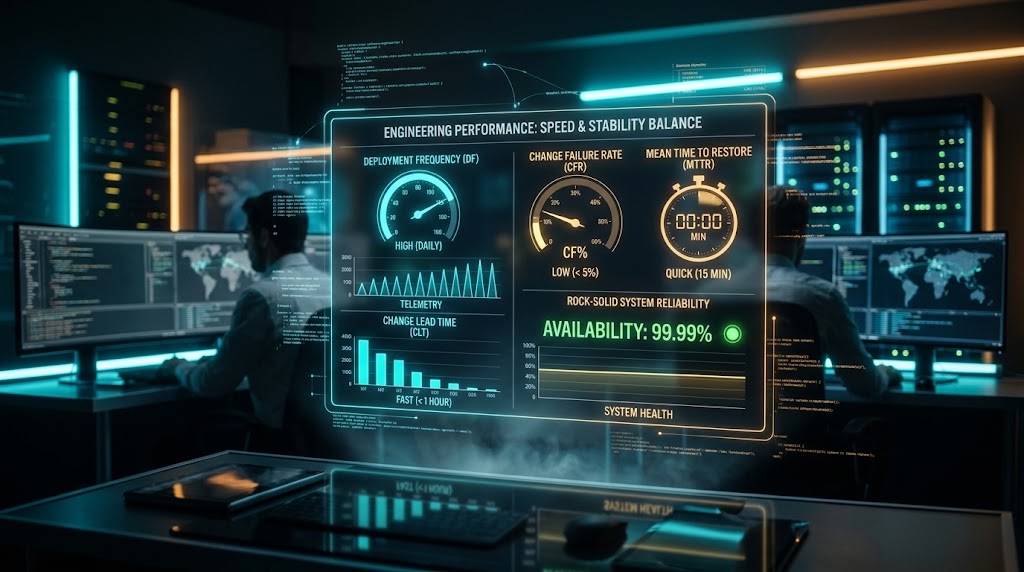
Brzina i stabilnost nisu suprotnosti (DORA metrike za 2026)
Jedna od najvažnijih empirijskih lekcija DevOps istraživanja jeste rušenje mita da kompanije moraju da biraju između brzine i stabilnosti. Podaci godinama unazad pokazuju da visokoperformantni timovi istovremeno postižu i maksimalnu brzinu i najviši nivo pouzdanosti.
Savremeni DORA model meri performanse isporuke softvera (Software Delivery Performance) kroz pet ključnih metrika podeljenih u dve grupe:
1. Protok promena (Throughput):
-
Vreme vođenja promene (Change Lead Time): Vreme koje protekne od trenutka commit-a koda do njegovog uspešnog puštanja u produkciju.
-
Učestalost isporuke (Deployment Frequency): Koliko često se promene koda puštaju u produkciono okruženje.
2. Stabilnost sistema (Instability):
-
Vreme oporavka od neuspelog deploymenta (Failed Deployment Recovery Time): Koliko je vremena potrebno da se servis vrati u funkcionalno stanje nakon incidenta u produkciji.
-
Stopa neuspešnih promena (Change Fail Rate): Procenat isporuka u produkciju koje zahtevaju hitnu sanaciju, zakrpu ili rollback.
-
Stopa dorade deploymenta (Deployment Rework Rate): Procenat deploymenta koji predstavljaju neplanirani rad nastao radi otklanjanja problema izazvanih prethodnim promenama.
Ovakav pristup sprečava manipulaciju statistikom: puštanje koda na svakih sat vremena nije uspeh ukoliko svaka druga isporuka ruši bazu podataka ili stvara incidente.
 Continuous Integration nije samo „imamo Jenkins“
Kontinuirana integracija (Continuous Integration – CI) često se pogrešno poistovećuje sa softverskim alatima. Konstatacija „koristimo GitHub Actions“ ili „imamo podešen Jenkins“ ne znači nužno da tim praktikuje CI.
CI je prvenstveno inženjerska disciplina:
-
Programeri integrišu svoje promene u glavnu granu (main/trunk) često, obično više puta dnevno.
-
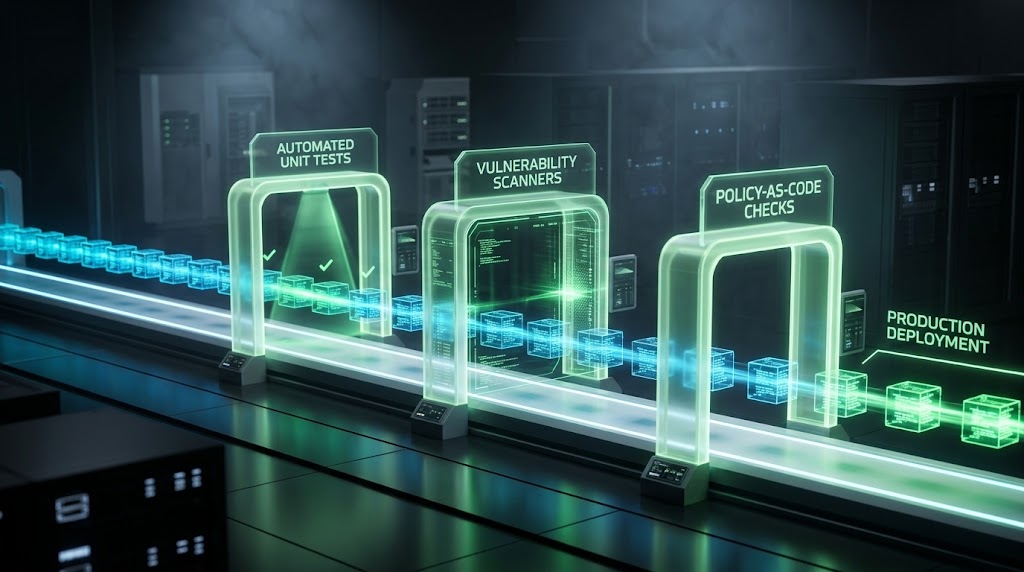
Svaki commit automatski pokreće nezavisni build i sveobuhvatnu bateriju testova.
-
Statička analiza koda, bezbednosne provere i analiza zavisnosti izvršavaju se u realnom vremenu.
Kada se radi u malim inkrementima, integracioni problemi se uočavaju i rešavaju u roku od nekoliko minuta. Ako tim čeka tri nedelje da spoji izolovane grane (branches) sa stotinama promena, nastaje „integracioni pakao“ (Integration Hell) koji nijedan softverski alat ne može samostalno da reši.
Continuous Delivery i Continuous Deployment nisu ista stvar
U praksi je važno precizno razlikovati ova dva koncepta:
-
Continuous Delivery (Kontinuirana isporuka): Podrazumeva da se svaka promena koda automatski testira i priprema za produkciju kroz standardizovani pipeline. Softver je u svakom trenutku u stanju spremnom za izdanje (Deployable State), ali sam trenutak puštanja može zavisiti od manuelnog odobrenja ili poslovne strategije.
-
Continuous Deployment (Kontinuirano puštanje): Predstavlja korak dalje u automatizaciji – svaka promena koja prođe sve automatizovane kapije u cevovodu automatski i bez ljudske intervencije završava u produkciji.
Continuous Deployment nije univerzalan recept za svaku organizaciju. Bankarski sistemi, medicinski softver ili industrijska kontrola imaju specifične profile rizika i regulatorne zahteve koji se razlikuju od SaaS aplikacija ili digitalnih medija. Međutim, svaka kompanija može i treba da teži kontinuiranoj isporuci: da sam proces puštanja bude potpuno automatizovan, ponovljiv i predvidljiv.
Tehničke osnove i alati koji čine srž ovih praksi detaljno su analizirani u našem vodiču „Svet DevOps-a: šta je, zašto je važan i kako započeti karijeru u DevOps-u“.
Pravi DevOps počinje kada Deployment prestane da bude događaj
U tradicionalnim IT organizacijama puštanje nove verzije softvera liči na vanredno stanje: petak kasno uveče, desetine inženjera na koordinacionom pozivu, tabele sa stotinama koraka, ručni backup baze i tenzija.
To nije dokaz inženjerske ozbiljnosti – to je simptom rizičnog i nepouzdanog procesa. Ako svaka isporuka zahteva herojski podvig inženjera, sistem isporuke je neadekvatan.
Zrela DevOps organizacija pretvara puštanje softvera u rutinsku, gotovo neprimetnu aktivnost:
Mala promena -> Automatska verifikacija -> Tihi deployment -> Praćenje metrika -> Gotovo.
Ako se pojavi neočekivani problem, sistem ga automatski izoluje i primenjuje rollback ili roll-forward proceduru. Bez stresa, bez vanrednih poziva i bez zaustavljanja rada korisnika.
Veliki Release je organizacioni rizik
Rizik produkcije je u direktnoj srazmeri sa veličinom paketa promene (Batch Size):
-
Scenario A: Kompanija pušta novu verziju jednom u tri meseca. Paket sadrži 400 promena različitih timova. Kada sistem padne, pronalaženje tačne linije koda ili konfiguracije koja je izazvala kvar zahteva dane forenzičke analize.
-
Scenario B: Kompanija pušta promene svakodnevno u malim paketima od nekoliko commit-a. Ukoliko se pojavi degradacija performansi, uzrok se nepogrešivo identifikuje i otklanja za nekoliko minuta.
Smanjivanje paketa izmena jeste jedna od najvažnijih poluga za poboljšanje stabilnosti i brzine isporuke. Tu se DevOps direktno spaja sa agilnim principima: Agile nalaže razvoj u malim inkrementima, a DevOps obezbeđuje da se ti inkrementi jednako brzo i bezbedno isporučuju.
Funkcionalnost koja nije u produkciji još uvek nije proizvela vrednost
U mnogim timovima definicija završenog posla (Definition of Done) pati od lokalne kratkovidosti: programer prebaci tiket u status „Done“, ali kod čeka testno okruženje, bezbednosni audit i sledeći release prozor.
Za poslovanje i korisnika, ta funkcionalnost je jednaka nuli. Dok god softver ne rešava stvarni problem u rukama korisnika, sav uloženi rad predstavlja samo neangažovani kapital (Work in Progress).
DevOps proširuje definiciju završenog zadatka:
-
kod nije samo napisan i lokalno testiran;
-
kod je integrisan, automatizovano verifikovan, bezbednosno proveren;
-
konfigurisan je kroz infrastrukturu kao kod;
-
pokriven je telemetrijom i pušten u produkciju;
-
operativno je stabilan pod realnim saobraćajem.
DevOps ne znači da developer mora da postane sistem administrator
Izreka „You build it, you run it“ često se pogrešno interpretira kao zahtev da svaki programer mora postati vrhunski ekspert za konfiguraciju Linux kernela, umrežavanje, Kubernetes klastere i finu optimizaciju cloud troškova.
Zajednička odgovornost (Shared Ownership) ne podrazumeva brisanje specijalizacija. Ona podrazumeva uklanjanje silosa u kojima razvojni tim baci kod preko zida i prepusti operativcima da rešavaju probleme. Kroz interdisciplinarnu saradnju i inženjering platformi, programeri dobijaju autonomiju da samostalno upravljaju životnim ciklusom svojih servisa, bez potrebe da postanu inženjeri infrastrukture.
Platform Engineering je prirodna evolucija DevOps-a
Kako su organizacije rasle, srušeni zid između razvoja i operacija doveo je do novog izazova: ako svaki inženjerski tim samostalno konfiguriše svoj CI/CD cevovod, Kubernetes manifeste, logovanje i bezbednosne alate, nastaje masivna fragmentacija i dupliranje posla.
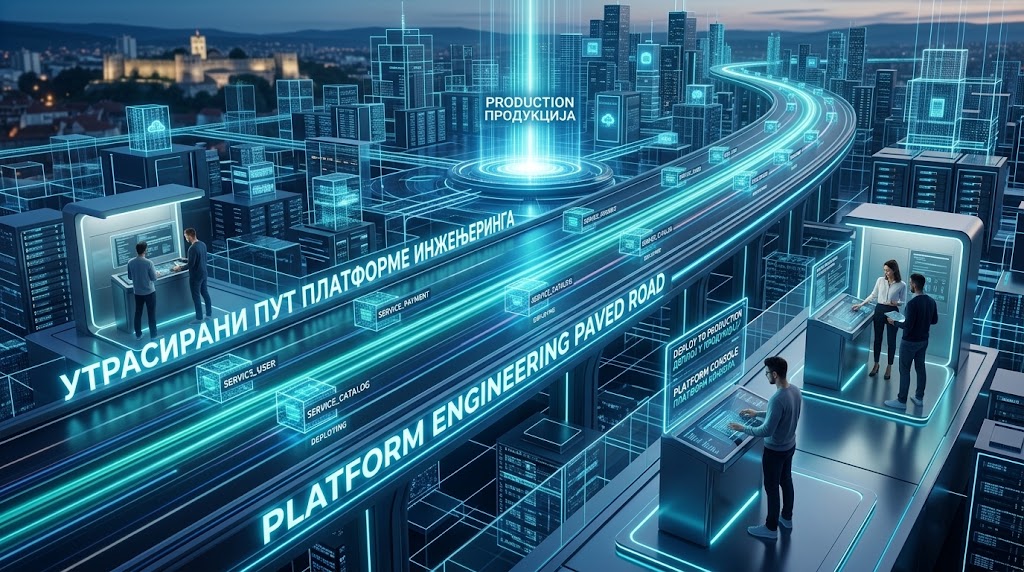
Platform Engineering rešava ovaj problem kroz izgradnju interne razvojne platforme (Internal Developer Platform – IDP):
-
Specijalizovani tim za platformu gradi samouslužne alate i utabane staze (Paved Roads).
-
Razvojni timovi jednim klikom ili definicijom dobijaju standardizovano okruženje sa ugrađenom bezbednošću, logovanjem i deployment logikom.
-
Eliminiše se potreba za otvaranjem tiketa centralnim infrastrukturnim timovima za svaku rutinsku operaciju.
Istraživanja DORA modela pokazuju da kvalitet interne platforme presudno utiče na sposobnost organizacije da pretoči prednosti novih tehnologija (uključujući generativni AI) u stvarne poslovne rezultate. Kada je kvalitet platforme visok, usvajanje automatizacije donosi skok produktivnosti; kada je platforma loša i fragmentisana, efekat novih alata se gubi u opštoj neorganizovanosti.
DevSecOps: bezbednost ne sme biti poslednja kontrolna tačka
Tradicionalni bezbednosni model je funkcionisao kao rampa na samom kraju projekta: nakon meseci razvoja, bezbednosni tim sprovede penetracione testove i zaključi da arhitektura ima kritične propuste. Projekat se vraća unazad, rokovi pucaju, a troškovi eksponencijalno rastu.
DevSecOps uvodi pomeranje bezbednosti ulevo (Shift-Left Security):
-
modelovanje pretnji (Threat Modeling) još u fazi dizajna,
-
automatsko skeniranje ranjivosti u zavisnostima (Dependency Scanning) pri svakom build-u,
-
statička (SAST) i dinamička (DAST) bezbednosna analiza integrisana u pipeline,
-
automatizovana kontrola curenja kredencijala i API ključeva,
-
definisanje bezbednosnih politika kroz kod (Policy as Code).
Cilj DevSecOps pristupa nije snižavanje bezbednosnih kriterijuma, već rano otkrivanje propusta onda kada je njihova ispravka najbrža i najjeftinija.
Infrastructure as Code menja operativni deo sistema
Infrastruktura kao kod (Infrastructure as Code – IaC) eliminiše ručno podešavanje servera i oslanjanje na znanje pojedinaca. Umesto nepouzdanih ručnih konfiguracija, celokupna infrastruktura se definiše programski:
-
konfiguracija se čuva u Git repozitorijumu,
-
svaka izmena prolazi kroz Code Review i Pull Request proceduru,
-
okruženja se kreiraju i gase automatizovano, identično i ponovljivo.
Ovo drastično smanjuje odstupanja u konfiguraciji (Configuration Drift) između razvojnih i produkcionih okruženja. Ipak, automatizacija sama po sebi ne garantuje kvalitet: loše projektovana arhitektura definisana kroz Terraform i dalje ostaje loša arhitektura, samo što se sada replicira znatno brže.
Observability zatvara krug između razvoja i stvarnog korisnika
Isporuka koda u produkciju nije kraj inženjerskog posla – to je početak validacije u realnom svetu. Opservabilnost (Observability) omogućava timu da na osnovu eksternih signala sistema razume njegovo unutrašnje stanje kroz:
-
Metrike (Metrics): Agregirani podaci o performansama, protoku i greškama.
-
Zapise (Logs): Detaljni vremenski označeni zapisi o specifičnim događajima.
-
Tragove (Traces): Praćenje putanje pojedinačnog korisničkog zahteva kroz distribuirane mikroservise.
Za razliku od klasičnog monitoringa koji samo javlja da je server pao, opservabilnost otkriva koji tačno mikroservis izaziva kašnjenje na checkout-u, koje korisničke grupe su pogođene i sa kojim tačno commit-om je problem počeo. Tu se petlja sa Agile-om u potpunosti zatvara: isporuka donosi podatke, podaci generišu učenje, a učenje usmerava sledeći sprint.
 Incident nije samo problem koji treba ugasiti – to je prilika za učenje
Zrela DevOps kultura prepoznaje incidente kao neizbežan deo kompleksnih distribuiranih sistema. Primarni zadatak tokom incidenta jeste što brži oporavak servisa, ali ključna faza nastupa nakon toga kroz analizu bez prebacivanja krivice (Blameless Postmortem).
Ukoliko organizacija na incident odgovori traženjem krivca, rezultat je prikrivanje problema i strah od inovacija. Kada se fokus pomeri na sistemske faktore – zašto automatski testovi nisu prepoznali rubni slučaj, zašto je telemetrija zakasnila i kako sistem učiniti otpornijim na ljudske greške – incident postaje izvor trajnog inženjerskog unapređenja.
DevOps bez kulture je samo skup alata (Toolchain)
Kompanija može investirati stotine hiljada evra u moderne cloud licence, Kubernetes klastere i automatizovane alate, a da suštinski ostane na nivou prevaziđenog radnog modela:
-
inženjeri nemaju pristup telemetriji iz produkcije,
-
operativci ne razumeju poslovnu svrhu funkcionalnosti,
-
bezbednosni tim blokira rad na samom kraju ciklusa,
-
svaka sitna promena zahteva više nivoa menadžerskih odobrenja.
To nije DevOps transformacija, već stari birokratski sistem opremljen savremenim alatima. DevOps je u svojoj biti kulturni pomak ka zajedničkoj odgovornosti, transparentnosti i rušenju međuresornih barijera.
Najgori DevOps tim je često onaj koji se zove „DevOps tim“
Formiranje posebnog odeljenja koje nosi naziv „DevOps tim“ često stvara novi silos umesto da ruši postojeće: programer napiše kod, pošalje tiket „DevOps timu“, a oni ga potom puštaju u rad. U tom scenariju ništa se suštinski nije promenilo – sistem je samo dobio moderniji naziv za nekadašnji Operations tim.
Specijalizovani inženjerski timovi imaju puni smisao kada su organizovani kao timovi za internu platformu (Platform Engineering) ili pouzdanost sistema (Site Reliability Engineering – SRE), sa misijom da izgrade samouslužne servise i automatizaciju koji drugim timovima omogućavaju nesmetanu samostalnost.
Upravljanje promenama zasnovano na riziku (Risk-Based Change Management)
U mnogim korporacijama Odbor za odobrenje promena (Change Advisory Board – CAB) predstavlja glavno usko grlo: bezazlena izmena teksta na stranici i fundamentalna migracija baze podataka čekaju isti nedeljni sastanak kako bi dobile formalno odobrenje.
Zreo inženjerski pristup primenjuje upravljanje promenama zasnovano na proceni rizika:
-
Niskorizične promene (Standard Changes): Pokrivene automatizovanim testovima, proverene kroz CI/CD i lako reverzibilne, idu u produkciju odmah, bez ikakvih administrativnih prepreka.
-
Visokorizične promene: Zahtevaju multidisciplinarni pregled arhitekture, detaljne planove mitigacije i postepeno puštanje.
Empirijski podaci potvrđuju da teški, formalni i eksterni procesi odobravanja ne smanjuju stopu incidenata, već samo drastično usporavaju poslovanje i gomilaju rizik kroz veće pakete promena.
Progresivna isporuka: Canary, Feature Flags i Blue-Green modeli
Tradicionalno shvatanje podrazumevalo je da je novo izdanje softvera binaran događaj: verzija ili nije puštena ili je dostupna svim korisnicima odjednom.
Savremeni sistemi primenjuju progresivnu isporuku (Progressive Delivery):
-
Zastavice funkcionalnosti (Feature Flags): Kod se može nalaziti u produkciji, ali funkcionalnost ostaje nevidljiva za korisnike dok se ne aktivira konfiguracijski.
-
Canary Release: Nova verzija se inicijalno usmerava ka malom segmentu korisnika (npr. 1-2% saobraćaja). Ukoliko telemetrija ne beleži greške, udeo se postepeno povećava.
-
Blue-Green Deployment: Održavaju se dva identična produkciona okruženja, pri čemu se saobraćaj u sekundi preusmerava na novu verziju preko rutera, uz mogućnost trenutnog vraćanja unazad.
Ove tehnike prenose eksperimentalnu prirodu agilnog razvoja direktno u produkciono okruženje: hipoteza se proverava na realnom uzorku bez izlaganja celokupnog poslovanja riziku.
DevOps i Kanban: upravljanje protokom kroz ceo sistem
Kanban metodologija stavlja fokus na vizualizaciju toka, identifikaciju uskih grla i ograničavanje rada u toku (Work in Progress – WIP). DevOps proširuje ove principe sa nivoa zadataka na nivo celokupnog lanca isporuke softvera.
Kao što smo detaljno analizirali u tekstu „Scrum, Kanban ili hibridni model: izbor metodologije prema karakteristikama IT projekta“, suština efikasnosti leži u optimizaciji protoka, a ne u formi sastanaka. Kada tim mapira svoj lanac vrednosti (Value Stream Mapping), često otkriva poraznu činjenicu:
-
aktivno pisanje koda traje dva dana;
-
čekanje na Code Review traje dva dana;
-
čekanje na QA okruženje traje tri dana;
-
čekanje na bezbednosnu proveru traje pet dana;
-
čekanje na deployment prozor traje sedam dana.
Od ukupno tri nedelje ciklusa, na stvaran rad odlazi manje od tri dana – sve ostalo je vreme čekanja. DevOps rešava problem zastoja u sistemu, a ne brzinu kucanja programera.
AI u 2026. godini: zašto je DevOps postao još važniji
Eksplozija autonomnih AI agenata za kodiranje menja dinamiku razvoja: inženjeri danas mogu višestruko brže da izgenerišu kod, napišu testove i pripreme Pull Requestove.
Međutim, DORA istraživanja identifikuju fenomen pod nazivom AI Amplifier Effect (Efekat AI pojačivača): veštačka inteligencija pojačava postojeće osobine inženjerskog sistema.
-
Ukoliko organizacija poseduje robustan CI/CD cevovod, visoku pokrivenost automatizovanim testovima i zrelu internu platformu, AI ubrzava isporuku stvarne vrednosti.
-
Ukoliko je sistem isporuke spor, ručan i fragmentisan, AI agenti samo munjevito gomilaju kod koji stoji u redu i guši tim u procesima verifikacije.
Štaviše, noviji podaci pokazuju da se deo vremena ušteđenog kroz AI generisanje koda sada preliva u faze revizije, bezbednosne provere i testiranja. Bez rigoroznih DevOps praksi, ubrzanje na nivou pojedinca stvara zagušenje na nivou organizacije, što smo analizirali i u tekstu „Agilno IT poslovanje u eri veštačke inteligencije: kako AI menja Scrum, Kanban i upravljanje projektima“.
SRE i DevOps: inženjerski okvir za pouzdanost
Site Reliability Engineering (SRE) predstavlja praktičnu inženjersku implementaciju DevOps filozofije kroz egzaktnu matematiku pouzdanosti:
-
SLI (Service Level Indicator): Merljivi parametar performansi servisa u realnom vremenu (npr. latencija ili stopa uspešnih zahteva).
-
SLO (Service Level Objective): Ciljna vrednost pouzdanosti dogovorena sa poslovanjem (npr. 99.9% uspešnih zahteva tokom meseca).
-
Budžet za greške (Error Budget): Dozvoljeni prostor za nestabilnost (u slučaju 99.9% dostupnosti, to je 0.1% neuspeha).
Error Budget uvodi racionalan balans između inovacija i stabilnosti: dokle god je tim unutar budžeta za greške, može agresivno da pušta nove funkcionalnosti i preuzima rizik. Onog trenutka kada se budžet potroši, prioriteti se automatski prebacuju sa novih funkcionalnosti na inženjering pouzdanosti i stabilizaciju sistema.
DevOps nije cilj – brža i bezbednija isporuka vrednosti jeste
Krajnji korisnik ne kupuje Kubernetes klastere, Terraform module niti savršeno konfigurisane pipeline faze. Korisnik očekuje servis koji radi pouzdano, rešava njegov problem i brzo donosi potrebna unapređenja. DevOps je, baš kao i Agile, samo inženjersko sredstvo za postizanje tog cilja.
Isti princip važi u svim segmentima digitalnog poslovanja. Kao što agencija Joombooz ističe u svojoj analizi o tome zašto redovno održavanje web sajta i web shopa predstavlja kontinuirani proces a ne jednokratan čin, tako i u razvoju softvera lansiranje verzije označava tek početak operativnog ciklusa učenja, zaštite i optimizacije.
Kako prepoznati zrelu DevOps organizaciju?
Umesto prebrojavanja alata u tehnološkom steku, nivo zrelosti organizacije procenjuje se kroz jasna operativna pitanja:
-
Koliko vremena protekne od commit-a koda do njegove aktivacije u produkciji?
-
Koliko često tim može bezbedno da isporuči promene krajnjim korisnicima?
-
Koliki procenat deploymenta prolazi bez potrebe za vanrednim intervencijama?
-
Koliko minuta je potrebno za potpuni oporavak servisa u slučaju kritičnog incidenta?
-
Da li razvojni tim ima neposredan uvid u produkcionu telemetriju i ponašanje servisa?
-
Da li je bezbednost integrisana u rane faze razvoja ili deluje kao eksterna rampa?
-
Da li je proces puštanja u rad rutinski i predvidljiv, ili zahteva prekovremeni rad i vanredna stanja?
Ukoliko puštanje softvera u produkciju i dalje zahteva heroizam pojedinaca, DevOps transformacija u toj organizaciji još uvek nije završena.
DevOps završava ono što je Agile započeo
Agilni manifest je oslobodio razvoj softvera iz zamke višemesečnog planiranja i rada naslepo, uvodeći iterativni razvoj i brže prikupljanje povratnih informacija. DevOps zatvara taj krug uklanjanjem barijera između završenog koda i produkcije.
Stvarna agilnost ne prestaje u trenutku kada inženjer zatvori radni zadatak na tabli. Ona se ostvaruje tek onda kada korisnik dobije novu vrednost, a tim prikupi teleometrijske podatke na osnovu kojih donosi sledeću poslovnu odluku. DevOps zato nije zamena za Agile niti alternativna metodologija – on predstavlja njegov neophodan inženjerski temelj.
 FAQ – DevOps i Agile
Šta je DevOps?
DevOps je skup organizacionih, kulturnih i inženjerskih praksi koji ujedinjuje razvoj (Development) i operacije (Operations) sa ciljem skraćenja životnog ciklusa isporuke softvera uz očuvanje visokog nivoa stabilnosti i kvaliteta.
Kakva je veza između Agile-a i DevOps-a?
Agile optimizuje brzinu planiranja i razvoja kroz iteracije i povratne informacije, dok DevOps proširuje te principe kroz kompletan inženjerski lanac: automatsku integraciju, bezbednost, infrastrukturu, deployment i praćenje u produkciji.
Da li je DevOps agilna metodologija?
DevOps nije metodološki okvir poput Scrum-a ili Kanban-a. To je operativni i tehnički model rada koji agilnim timovima obezbeđuje infrastrukturu i praksu za kontinuiranu isporuku vrednosti.
Da li se DevOps svodi samo na CI/CD automatizaciju?
Ne. CI/CD je ključna tehnička komponenta, ali DevOps obuhvata organizacionu kulturu deljene odgovornosti, inženjering pouzdanosti, bezbednost kroz kod, opservabilnost i kontinuirano unapređenje procesa.
Šta je Continuous Integration (CI)?
Kontinuirana integracija je inženjerska praksa u kojoj programeri često spajaju svoje promene u centralni repozitorijum, gde se svaki unos automatski verifikuje kroz build proces i testove radi ranog otkrivanja grešaka.
Koja je razlika između Continuous Delivery i Continuous Deployment pristupa?
Continuous Delivery podrazumeva da je softver nakon automatizovanog testiranja uvek spreman za puštanje, ali sam deployment u produkciju može zahtevati manuelno odobrenje. Continuous Deployment automatski pušta u produkciju svaku promenu koja uspešno prođe testove.
Da li je Continuous Deployment obavezan za sve kompanije?
Nije. Nivo automatizacije deploymenta zavisi od poslovnog modela, regulatornog okvira i profila rizika. Mnogi sistemi zahtevaju plansko i kontrolisano puštanje, ali i dalje imaju ogromnu korist od Continuous Delivery praksi.
Koje su ključne DORA metrike u 2026. godini?
DORA meri performanse kroz pet metrika: vreme vođenja promene (Change Lead Time), učestalost deploymenta (Deployment Frequency), vreme oporavka od neuspeha (Failed Deployment Recovery Time), stopu neuspešnih promena (Change Fail Rate) i stopu dorade deploymenta (Deployment Rework Rate).
Zašto je DORA uvela stopu dorade deploymenta (Deployment Rework Rate)?
Ova metrika meri udeo neplaniranog inženjerskog rada koji se troši na ispravljanje problema nastalih usled prethodnih deploymenta, čime se preciznije meri stvarna nestabilnost procesa isporuke.
Šta označava termin DevSecOps?
DevSecOps predstavlja integraciju bezbednosnih praksi, alata i provera u sve faze razvojnog i isporučnog ciklusa od samog početka, umesto tretiranja bezbednosti kao izolovane kontrole na kraju projekta.
Šta je Infrastructure as Code (IaC)?
IaC je praksa upravljanja i konfigurisanja serverske i mrežne infrastrukture kroz strogo verzionisane deskriptivne datoteke, čime se obezbeđuje ponovljivost, transparentnost i automatizacija okruženja.
Šta je Platform Engineering i kako se odnosi prema DevOps-u?
Platform Engineering gradi interne samouslužne platforme (IDP) koje razvojnim timovima obezbeđuju standardizovane alate za deployment, monitoring i bezbednost. To je način na koji se DevOps principi skaliraju u velikim organizacijama bez preopterećenja programera.
Koja je razlika između klasičnog monitoringa i opservabilnosti?
Monitoring prati unapred definisane metrike i upozorava kada sistem otkaže. Opservabilnost koristi metriku, logove i distribuirane tragove da objasni zašto je došlo do anomalije u kompleksnom i nepredvidivom okruženju.
Šta je Site Reliability Engineering (SRE)?
SRE je inženjerska disciplina nastala u kompaniji Google koja primenjuje principe softverskog inženjeringa na operativne probleme, balansirajući inovacije i pouzdanost kroz SLI parametre, SLO ciljeve i budžete za greške (Error Budgets).
Zašto su mali paketi promena (Small Batches) bezbedniji za produkciju?
Manje izmene u kodu je lakše testirati, pregledati i razumeti. Ukoliko dođe do incidenta, znatno je lakše izolovati uzrok problema i brzo primeniti popravku ili vratiti verziju unazad.
Da li formiranje zasebnog „DevOps tima“ rešava problem silosa?
Često ne rešava, već samo stvara novi posrednički silos ukoliko taj tim služi isključivo za manuelno preuzimanje i puštanje koda. Timovi treba da budu organizovani oko platforme koja osnažuje autonomiju razvojnih jedinica.
Kako veštačka inteligencija utiče na DevOps u 2026. godini?
AI dramatično ubrzava generisanje koda i pripremu zadataka, ali time stvara pritisak na ostatak sistema. Bez automatizovanih kapija kvaliteta i zrelih DevOps pipeline-a, povećani volumen koda samo stvara zastoje u testiranju i bezbednosnoj verifikaciji.
Šta je Value Stream Mapping i kako pomaže timovima?
To je tehnika vizuelnog mapiranja svih koraka u procesu isporuke koja meri vreme aktivnog rada naspram vremena čekanja, precizno ukazujući na organizaciona i tehnička uska grla u sistemu.
Kako prepoznati da je DevOps proces uspešno implementiran?
Kada puštanje softvera u produkciju postane predvidljiva, rutinska i neprimetna aktivnost koja se odvija u toku radnog vremena, bez vanrednih stanja, stresa i zastoja u radu krajnjih korisnika.