
Ključne teze – šta je najbitnije u tekstu
Multimodal AI (multimodalna veštačka inteligencija) označava sisteme koji mogu da razumeju ili generišu više različitih tipova informacija – tekst, slike, zvuk, video, dokumente i druge medijske formate – povezujući značenje među njima.
Najvažnije promene obuhvataju sledeće aspekte:
-
AI više ne mora prvo da pretvori svaki medij u tekst da bi mogao da ga razume; savremeni sistemi sve više rade sa različitim modalitetima unutar zajedničkog reprezentacionog prostora.
-
Google je tokom 2026. godine predstavio Gemini Embedding 2, koji tekst, slike, video, audio i dokumente mapira u zajednički prostor reprezentacija (embedding space), što omogućava semantičku pretragu i povezivanje sadržaja nezavisno od njegovog formata.
-
Gemini Omni ide korak dalje: kombinuje tekst, sliku, video i audio kao ulazne podatke, uz mogućnost generisanja i montiranja video-materijala kroz konverzacioni interfejs.
-
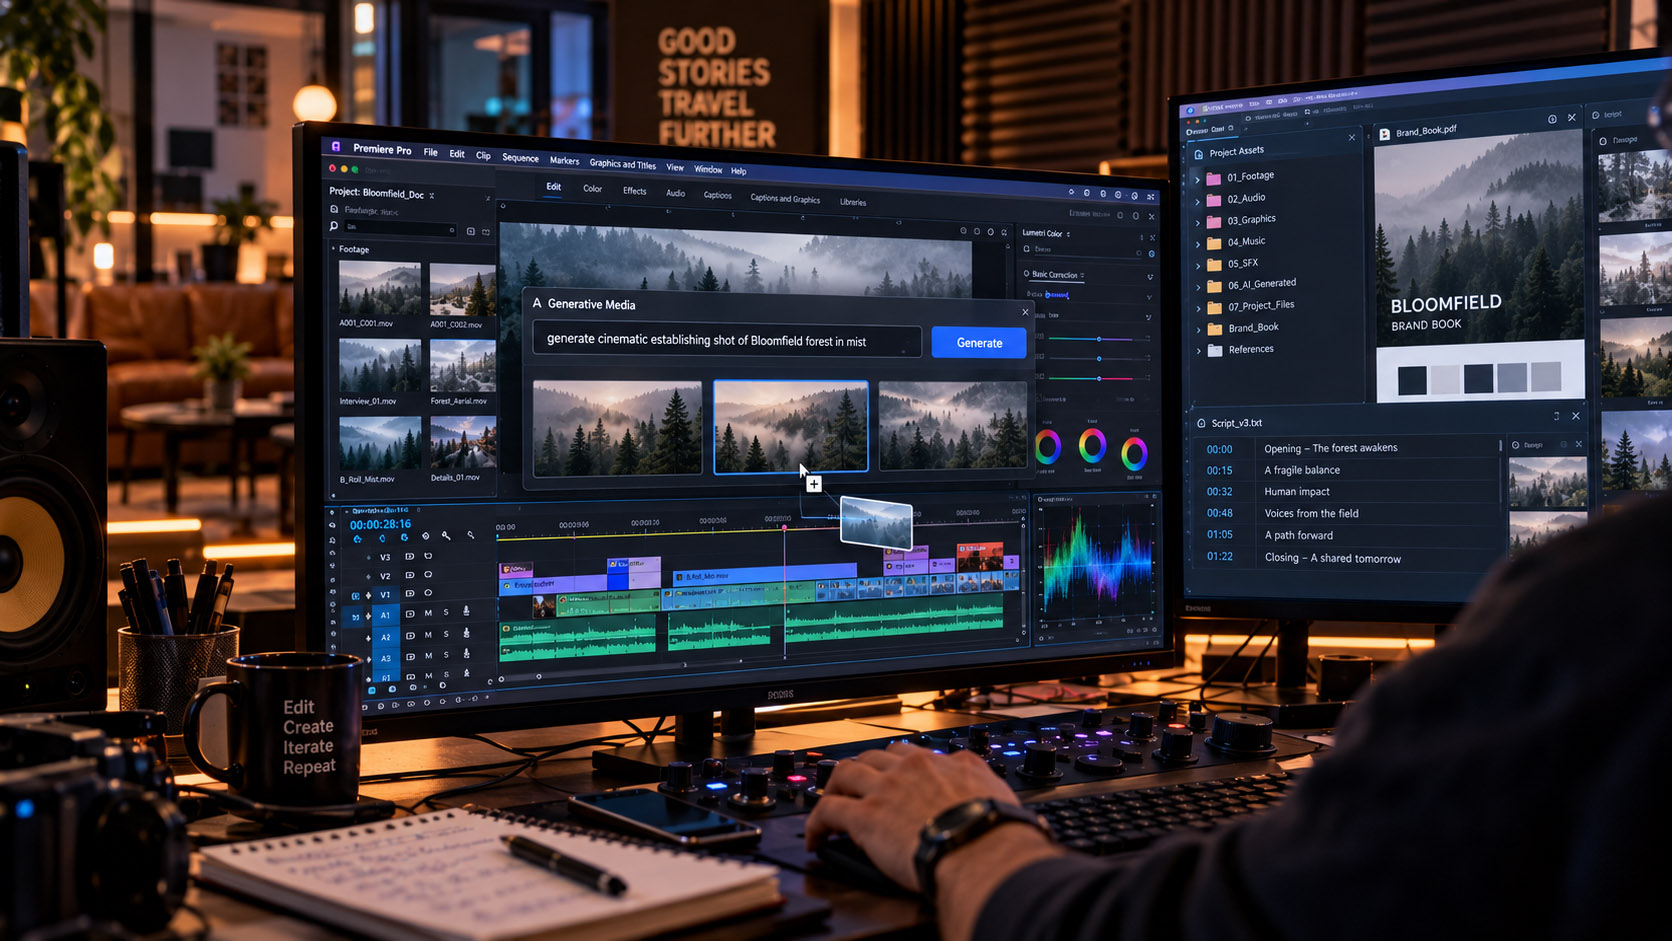
Adobe tokom 2026. spaja generisanje slika, videa i zvuka, upravljanje resursima i video Timeline u sve integrisaniji kreativni prostor, dok Premiere omogućava kreiranje video-sekvenci i zvučnih efekata direktno unutar same montaže.
-
Tradicionalni radni tok „tekst → Photoshop → Premiere → audio alat → prevod → export“ biće zamenjen jedinstvenim multimodalnim produkcionim okruženjem.
-
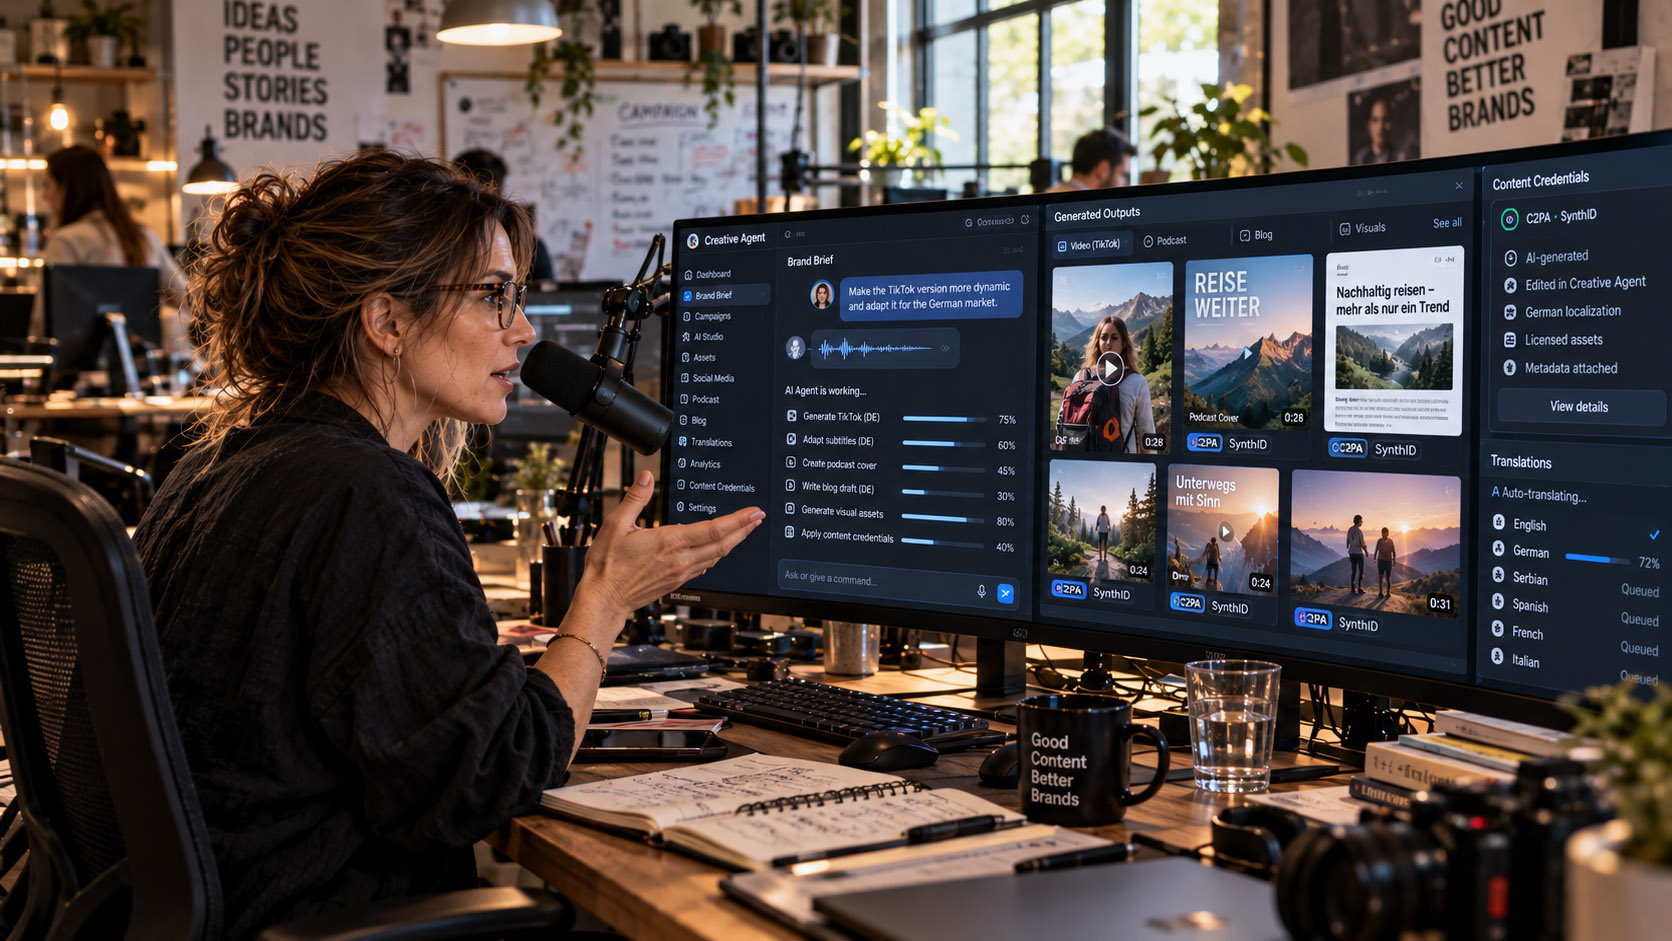
Jedan osnovni sadržaj može automatski postati članak, Reel, isečak za podcast, ilustracija, transkript, lokalizovana video-verzija ili interaktivni resurs.
-
Najveća vrednost multimodalnog pristupa nije u pukom štancovanju veće količine sadržaja, već u tome što dramatično smanjuje vreme do prve upotrebljive verzije (Time to First Viable Version).
-
Kako generisanje postaje jeftinije, stvarna vrednost se pomera ka kreativnoj direkciji, selekciji, originalnoj ideji, verifikaciji i odgovornosti.
-
Multimodalni sistemi donose i veće rizike: pogrešno povezivanje vizuelnog i tekstualnog konteksta, dipfejk materijale, zloupotrebu identiteta, greške u proizvodima, povrede autorskih prava i eroziju poverenja u digitalne medije.
-
Od 2. avgusta 2026. godine u Evropskoj uniji primenjuju se relevantne obaveze transparentnosti iz člana 50 Zakona o veštačkoj inteligenciji (EU AI Act) za određene generativne i interaktivne AI sisteme i sintetički sadržaj.
Najkraće rečeno: do sada smo birali softver prema formatu sadržaja. U budućnosti ćemo opisivati šta želimo da postignemo, a AI sistem će sam birati modalitet i alat koji treba upotrebiti. To je fundamentalna promena, a ne samo još jedan generator slika.
 Multimodal AI nije „ChatGPT koji ume da vidi sliku“
Prva generacija AI asistenata funkcionisala je po strogo tekstualnom principu: postavite pitanje u formi teksta i dobijete tekstualni odgovor. Ako je bilo potrebno analizirati fotografiju, koristio se zaseban Computer Vision sistem. Za obradu govora postojao je poseban Speech-to-Text model, dok je za generisanje slika korišćena sasvim druga arhitektura. Čitav sistem delovao je kao skup specijalizovanih mašina koje sa prekidima razmenjuju međurezultate.
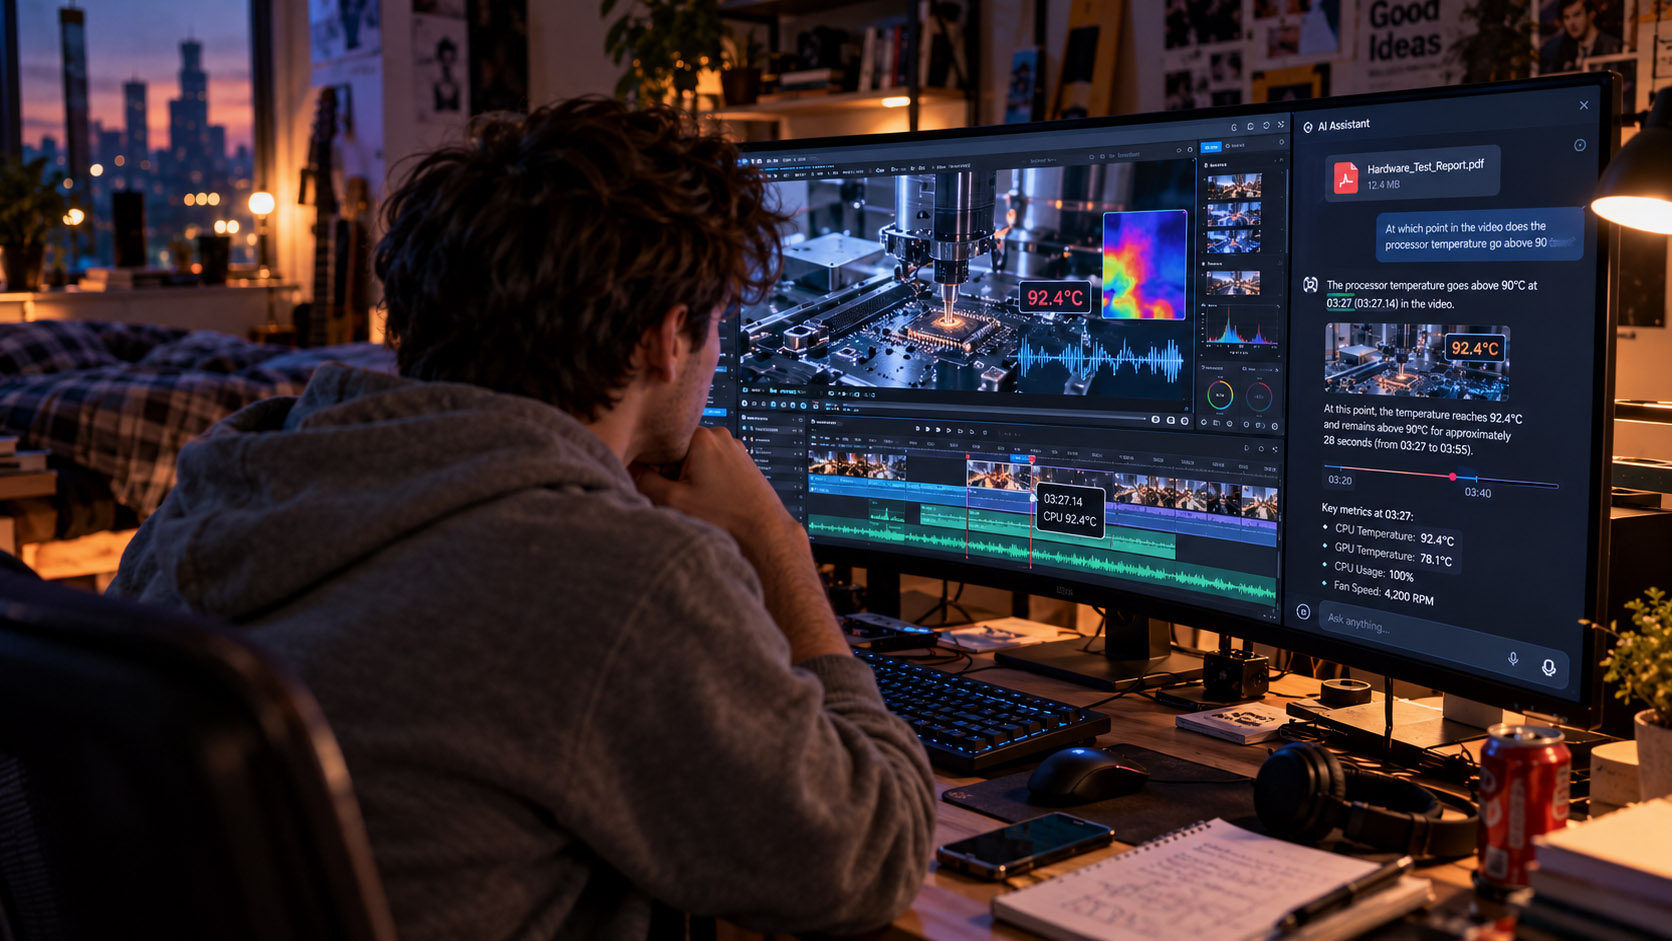
Multimodal AI iz korena menja ovu arhitekturu. Model danas može istovremeno da primi fotografiju proizvoda, PDF tehničku specifikaciju, video-snimak korisnika koji ga testira, audio-komentar i konkretno pitanje: „Šta u ovom videu nije u skladu sa tehničkim specifikacijama proizvoda?“
To je potpuno nova dimenzija mašinske inteligencije. Ne zato što model samo „vidi“, već zato što mora da poveže ono što vidi, čuje i pročita sa onim što korisnik želi da sazna. Taj proces naziva se zaključivanje između modaliteta (cross-modal reasoning).
Prava revolucija je u povezivanju značenja
Zamislimo video-klip u trajanju od dvadeset minuta: autor govori o novom laptopu, na ekranu se na trenutak pojavljuje grafikon sa benčmark testovima, kamera prikazuje raspored portova, a u jednom kadru se čuje i vidi problem sa bučnim ventilatorom.
Tradicionalni pretraživači u ovakvim situacijama traže isključivo tekstualne tragove. Ako video nema savršeno optimizovan naslov, detaljan opis ili transkript, velika većina informacija u njemu ostaje zaključana i nevidljiva. Multimodalni sistem, s druge strane, ravnopravno razume govor, sliku, grafiku, tekst unutar kadra i pojedinačne objekte. Korisnik može direktno postaviti pitanje: „Na kom mestu u videu autor pokazuje temperaturu procesora iznad 90 stepeni?“ To više nije obično pretraživanje po ključnim rečima (keyword search), već prava semantička pretraga kroz sirovi video-materijal.
Googleov model Gemini Embedding 2, predstavljen u martu 2026. godine, razvijen je upravo sa tim ciljem: tekst, slike, video, audio i dokumente mapira u jedan jedinstveni prostor reprezentacija (unified embedding space), uz podršku za više od 100 jezika. Ova tehnologija donosi ogromne promene u radu sa CMS platformama, digitalnim arhivama, medijskim kućama, obrazovnim sistemima i platformama za elektronsku trgovinu.
Fajl više nije najvažnija jedinica sadržaja
Decenijama smo digitalni rad posmatrali kroz strogo definisane formate: članak je tekstualni dokument (.docx), vizuelni element je slika (.jpg), video-zapis je .mp4 fajl, a zvuk je audio-snimak (.wav). Međutim, za multimodalni AI sistem sve su to samo različite reprezentacije jedne te iste informacije.
Kada danas snimite intervju sa nekim stručnjakom, od tog materijala možete napraviti video, podcast, transkript, članak, kratke Reels klipove i citate za društvene mreže. To radimo i sada, ali multimodalni AI vodi ka okruženju u kome svaki od ovih formata ne moramo da kreiramo kao potpuno zaseban produkcioni projekat. Osnovna jedinica rada postaje izvorna ideja ili osnovni resurs (Source Idea ili Source Asset), dok su formati samo izvedene varijacije. Reč je o prelasku sa klasične produkcije sadržaja (Content Production) na transformaciju sadržaja (Content Transformation). Multimodal AI je tehnološki temelj koji tu transformaciju čini trenutnom i prirodnom.
Jedan razgovor može postati cela kampanja
Uzmimo za primer direktora kompanije koji je dao tridesetominutni intervju. Multimodalni produkcioni sistem u stanju je da u jednom prolazu uradi sledeće:
-
transkribuje razgovor sa visokom preciznošću,
-
prepozna vodeće teme i izdvoji najjače citate,
-
identifikuje momente sa najvećim emotivnim intenzitetom,
-
generiše strukturisan blog članak,
-
iseče šest kratkih video-formata spremnih za društvene mreže,
-
dizajnira privlačan thumbnail kadar,
-
automatski sinhronizuje titlove i prevede video na strane jezike,
-
napiše prateći opis za podcast platforme.
Ukoliko sistemu dostavite i fotografiju novog proizvoda, on je može prirodno uklopiti u promotivni kadar. Ako mu zadate smernice vizuelnog identiteta (Brand Guidelines), sistem će sve vizuelne izvedenice zadržati unutar zadatih boja i tipografije brenda. To više nije pojedinačni AI alat za jednu namenu, već celovit produkcioni ekosistem.
Gemini Omni pokazuje gde industrija pokušava da ode
Google je u maju 2026. predstavio porodicu modela Gemini Omni, čija je prva verzija, Omni Flash, definisana kao model sposoban da stvara iz bilo kog ulaznog formata, sa posebnim fokusom na video. Ovaj sistem kombinuje tekst, fotografiju, zvuk i video, generišući izlazni materijal koji se oslanja na njihovo zajedničko značenje, uz mogućnost direktnog uređivanja kroz razgovor.
To je mnogo značajniji iskorak nego što deluje na prvi pogled. Klasičan AI proces rada sa videom svodi se na unošenje tekstualnog opisa (prompta). Multimodalni proces, međutim, funkcioniše znatno bogatije: sistemu priložite fotografiju proizvoda, prošlogodišnju video-reklamu, audio-džingl i knjigu grafičkih standarda brenda, uz jednostavan zahtev: „Napravi novu verziju reklame od 20 sekundi u vertikalnom formatu, zadržavajući identitet originalne kampanje.“ Ovo pruža sasvim drugačiji nivo konteksta koji sam tekst nikada ne bi mogao da prenese.
 Prompt prestaje da bude jedini jezik kojim razgovaramo sa AI-jem
Godinama unazad inženjering promptova (Prompt Engineering) bio je tema broj jedan. Međutim, potpuno je neprirodno trošiti stotine reči kako biste do detalja opisali nijansu boje, kompoziciju kadra, teksturu odeće, izgled proizvoda ili lokaciju, kada možete jednostavno reći: „Koristi ovo“ – i priložiti fotografiju.
Vizuelne i zvučne reference ubrzano zamenjuju dugačke tekstualne opise:
-
Fotografija definiše tačan izgled karaktera;
-
Video pokazuje dinamiku i način kretanja;
-
Audio-snimak postavlja boju, ton i ritam glasa;
-
Dokument definiše pravila i tonalitet brenda;
-
Tekstualni prompt služi samo da naglasi šta tačno treba promeniti.
Ovo predstavlja znatno prirodniji, intuitivniji oblik interakcije između čoveka i računara (Human-Computer Interaction).
Budućnost AI kreativnog interfejsa verovatno je razgovor
Kreativni softver budućnosti neće tražiti beskonačno lutanje kroz menije niti podešavanje četrdeset različitih klizača. Umesto toga, komunikacija prelazi u domen razgovornog uređivanja (Conversational Editing), gde prirodnim jezikom usmeravate proces:
-
„Kadar je dobar, ali spusti kameru niže.“
-
„Zadrži ovu osobu, ali promeni pozadinsku lokaciju.“
-
„Muzika zvuči previše dramatično, prilagodi ton.“
-
„Skrati video na tačno 20 sekundi.“
-
„Od ovog segmenta napravi vertikalnu verziju za Instagram.“
Gemini Omni već postavlja temelje za ovakav način rada sa videom. Sa druge strane, integracija generativnih mogućnosti direktno u klasični Timeline, kakvu primenjuje Adobe, pokazuje komplementaran pravac: cilj nije brisanje profesionalnog softvera za montažu, već ugradnja inteligentnih funkcija unutar postojećih alata na koje su profesionalci navikli.
Adobe pokazuje da će granica između „generiši“ i „uredi“ nestati
Tokom 2026. godine Adobe Firefly je evoluirao u objedinjeni prostor za generisanje i uređivanje sadržaja u kome korisnik može na jednom mestu da kreira slike i video, organizuje radne resurse, primenjuje reference i montira kadrove na samoj vremenskoj liniji. Adobe ovo okruženje otvoreno pozicionira kao prostor koji spaja generisanje, obradu i organizaciju resursa.
Verzija Premiere 26.5 ide još direktnijim putem. Montažer na samom Timeline-u može obeležiti prazan prostor gde mu nedostaje kadar pokrivalice (B-roll), ukratko opisati traženu scenu, a sistem će automatski generisati video-klip ili zvučni efekat i ubaciti ga kao potpuno promenljiv segment u postojeću sekvencu. Generativni AI time prestaje da bude zasebna spoljna platforma i postaje osnovna funkcija montaže – jednako prirodna kao rez, skraćivanje (trim) ili tranzicija.
Još zanimljivije: jedan profesionalni program može da poziva različite modele
Možda i najvažniji trend u industriji nije pitanje koji je pojedinačni model najbolji na tržištu, već kako se oni koriste u praksi. Premiere-ov Generative Media Tool omogućava montažeru da bira između modela Adobe Firefly i podržanih partnerskih rešenja.
To jasno ocrtava budućnost u kojoj kreativni profesionalac neće morati da zna koji API stoji u pozadini, koja kompanija ga održava niti kakva serverska infrastruktura ga pokreće. Biće dovoljno reći: „Treba mi uvodni široki kadar (establishing shot)“, a sam program će odlučiti koji je generativni endžin najpogodniji za taj zadatak. Slično kao kod savremenih kamera na pametnim telefonima – dok fotografišemo, ne razmišljamo o tome koji procesor obrađuje svetlost, a koji uklanja šum, već posmatramo krajnji rezultat. Modeli veštačke inteligencije tako postaju nevidljiva infrastruktura.
Pobednički proizvod možda neće imati najbolji model – već najbolji orchestration
Poređenja u kreativnoj industriji danas se uglavnom svode na direktne duele: Model A protiv Modela B. Međutim, ako sistem može automatski da primeni model A za generisanje lica, model B za simulaciju fizike u videu, model C za kloniranje glasa, a model D za podizanje rezolucije (upscale), ključna prednost postaje nivo usklađenosti čitavog procesa.
Drugim rečima, orkestracija radnog toka (workflow orchestration) postaje važnija od performansi pojedinačnog modela. Konkurentska prednost u godinama pred nama neće biti puki pristup alatima – jer će ih imati svi – već veština da se oni uvežu u stabilan, predvidiv i pouzdan produkcioni sistem.
Kreativac više neće morati da bude ekspert u svakom alatu – ali moraće da razume svaki medij
Razvoj tehnologije donosi zanimljiv paradoks: alati postaju tehnički jednostavniji za upotrebu, ali kreativna odgovornost autora postaje znatno veća.
Ako AI samostalno montira kadrove, generiše vizuale, miksuje zvuk i sastavlja prateći tekst, kreativac više ne mora da provodi godine učeći prečice na tastaturi za svaki pojedinačni program. Ipak, on mora dubinski da razume kompoziciju, tipografiju, ritam, filmsku dramaturgiju, dizajn zvuka, harmoniju boja i strukturu narativa. Pre svega zato da bi odmah prepoznao gde je AI pogrešio. Osoba koja ne razume šta čini dobar kadar neće magično steći estetski ukus samo zato što joj generator isporučuje sliku u 4K rezoluciji – dobiće samo veći broj prosečnih predloga. Zbog toga kreativna procena (Creative Judgment) postaje jedna od najvažnijih i najtraženijih veština na tržištu.
AI spušta cenu produkcije – ali podiže cenu dobrog izbora
Nekada je izrada svakog vizuelnog koncepta bila skupa i dugotrajna, pa su se za prezentaciju pažljivo birala dva ili tri najbolja predloga. Danas AI za nekoliko sekundi može da ponudi stotinu različitih varijacija.
Time dolazimo do fenomena zvanog problem obilja generisanog sadržaja (Generation Abundance Problem): ako pred sobom imate 50 generisanih slika, 100 video-isečaka i 20 verzija glasa, vreme potrebno za pregled i selekciju postaje novo usko grlo produkcije. Budući alati će zato morati da ponude rešenja za automatsko rangiranje, semantičko grupisanje i prepoznavanje duplikata. Ali tu se otvara novo pitanje: želimo li zaista da isti algoritam i generiše opcije i samostalno odlučuje šta je od toga kvalitetno? U toj tački čovek mora da ostane nezaobilazna kontrolna instanca.
Multimodal AI može postati neverovatno moćan Brand Memory sistem
Zamislite da sistemu dostavite arhivu svih dosadašnjih reklama kompanije, logotipe, grafičke elemente, fotografije, muzičke teme, knjige standarda i video-intervjue, a zatim zatražite: „Osmisli novu kampanju koja dosledno prati vizuelni stil našeg brenda, ali ne ponavlja nijedan element iz ranijih oglasa.“
Multimodalno pretraživanje (Multimodal Retrieval) može precizno da mapira vizuelne obrasce, tekstualna pravila komunikacije i specifičan zvučni identitet. Gemini Embedding 2 trasira put za ovakve platforme jer različite formate postavlja u isti semantički prostor, stvarajući neku vrstu multimodalnog RAG sistema (Retrieval-Augmented Generation) za potrebe brenda. AI na taj način ne pretražuje samo tekstualne baze, već čitavu kreativnu memoriju jedne organizacije.
E-commerce će biti jedno od prvih velikih polja primene
Uzmimo tipičan primer iz elektronske trgovine: imamo fotografiju proizvoda, tabelu sa specifikacijama, recenzije kupaca, video-snimak otpakivanja i cenovnik. Multimodalni AI može u sekundi da generiše optimizovan opis, uporednu tabelu, kratku video-demonstraciju, vizuale za društvene mreže i personalizovan odgovor na specifičan upit kupca.
Kada kupac postavi pitanje: „Da li ova torba može da stane ispod avionskog sedišta?“, sistem povezuje dimenzije iz tehničkog lista sa vizuelnim proporcijama torbe i pravilima avio-kompanije. To je daleko korisnije i tačnije od dosadašnjih jednostavnih četbotova koji prepoznaju samo unapred definisane fraze.
 Mediji dobijaju novu vrstu digitalne redakcije
Za savremene medijske portale multimodalni radni tok donosi potpunu promenu ritma. Nakon objave autorskog teksta, sistem može samostalno da kreira audio-verziju za slušanje, vertikalni video za društvene mreže, infografiku i naslovnu ilustraciju.
Proces funkcioniše i u obrnutom smeru: sistemu se prosledi sirov video-snimak konferencije za štampu, on identifikuje govornike, transkribuje izjave, izdvoji ključne teze, uporedi ih sa pratećim zvaničnim dokumentima, predloži naslove i pronađe najčistiji kadar za naslovnu fotografiju. Novinar zatim samo proverava činjenice i finalizuje tekst. Brzina pripreme vesti se višestruko uvećava, ali ključna reč ostaje „proverava“ – u profesionalnom novinarstvu brzina nikada ne sme da potisne tačnost i odgovornost.
Multimodalna halucinacija može biti opasnija od tekstualne
Kada tekstualni model izmisli podatak, iskusno oko relativno lako uočava nelogičnost. Međutim, greške kod multimodalnih sistema znatno su suptilnije i teže za otkrivanje.
Model može da pogleda fotografiju, pogrešno protumači neki sitan vizuelni detalj, uveže ga sa potpuno nevezanim pasusom iz priloženog dokumenta i na osnovu toga sklopi izuzetno uverljivo, logično sročeno, ali potpuno netačno objašnjenje. Tako nastaje višestruka greška koja na prvi pogled deluje neprikosnoveno tačno. Sama činjenica da je sistem „video“ sliku nije garancija da ju je ispravno razumeo, zbog čega multimodalno zaključivanje obavezno mora da ima pouzdan kontrolni sloj za verifikaciju.
AI video dodatno komplikuje pojam dokaza
Fotografija i video decenijama su nosili tihu pretpostavku verodostojnosti: ono što je zabeleženo objektivom smatralo se dokazom da se događaj zaista odigrao. Generativna tehnologija nepovratno ruši taj aksiom, jer vizuelni realizam više ne garantuje autentičnost.
Kako multimodalni modeli napreduju, granice postaju neprimetne. Sistem može u istom kadru da spoji autentičnu fotografiju, sintetički generisano lice, stvaran glas sa modifikovanim tekstom i veštački kreiranu pozadinu. Pitanje u medijima više ne glasi: „Da li je ovo napravio AI?“, već: „Koji delovi ovog materijala su stvarni, šta je generisano i možemo li pouzdano da utvrdimo njegovo poreklo?“
Provenance će postati deo kreativnog workflow-a
Kao odgovor na ove izazove razvijaju se sistemi za potvrdu porekla i integriteta sadržaja, pre svega kroz standarde kao što su C2PA (Content Credentials), digitalne vodene žigove i namenske verifikacione interfejse. Tokom 2026. godine OpenAI je proširio svoje mehanizme za proveru porekla kombinovanjem C2PA metapodataka i SynthID vodenih žigova za podržane formate.
Važno je razumeti da metapodaci o poreklu ne garantuju da je sama tvrdnja u videu istinita. Oni služe da nedvosmisleno pokažu odakle fajl potiče, ko ga je kreirao, kojim je alatima menjan i da li u sebi nosi digitalne oznake veštačke inteligencije. Ovaj verifikacioni sloj postaće standardni deo profesionalne produkcije.
Regulativa već sustiže kreativni workflow
Od 2. avgusta 2026. godine u Evropskoj uniji stupaju na snagu obaveze transparentnosti definisane članom 50 Zakona o veštačkoj inteligenciji (EU AI Act). Za kreatore i distributere generativnih sistema uvode se zahtevi za mašinski čitljivo označavanje generisanih ili manipulisanih izlaza, dok oni koji primenjuju sisteme (deployers) moraju jasno da naznače kada je sadržaj sintetički generisan, naročito u slučajevima dipfejk formata ili tekstova od javnog značaja.
Regulativa predviđa specifične izuzetke i prelazne rokove za sisteme koji su na tržište plasirani pre navedenog datuma, tako da cilj nije postavljanje agresivnih vodenih žigova preko svakog kreativnog rada. Ipak, profesionalna produkcija više ne može ignorisati poreklo materijala, obavezno informisanje publike i prateće metapodatke.
Granica između kreativnog softvera i AI agenta će nestajati
Današnji programi za montažu pasivno čekaju komandu korisnika. Napredni multimodalni sistemi, međutim, počinju da preuzimaju proaktivnu ulogu: „Primećujem da nedostaje uvodni kadar između ove dve scene. Želiš li tri predloga usklađena sa stilom?“, ili: „Napravio sam grubi rez intervjua, izdvojio šest vertikalnih isečaka za društvene mreže, generisao titlove i pripremio naslovne slike.“
Softver time prestaje da bude samo pasivna alatka i prerasta u kreativnog agenta (Creative Agent). Kada takav sistem istovremeno operiše tekstom, slikom, zvukom, videom i podacima o gledanosti, on može autonomno da vodi znatne delove produkcije.
Agentic Multimodal AI je verovatno sledeća velika faza
Multimodalnost sistemu daje „čula“ kojima percipira svet, dok mu agentska arhitektura (Agentic AI) daje sposobnost konkretnog delovanja. Spoj ova dva koncepta znači da sistem može samostalno da pogleda video, razume projektni zadatak, pronađe odgovarajući resurs, generiše nedostajući kadar, montira sekvencu, proveri rezultat i nastavi sa sledećim korakom.
Ova integracija donosi korenitu transformaciju u upravljanju sadržajem (Content Operations). Ipak, u takvom okruženju kontrolne tačke odobrenja (Approval Gates) i stalno prisustvo čoveka u procesu (Human-in-the-Loop) postaju apsolutni imperativ. Činjenica da sistem može samostalno da privede projekat kraju ne znači da materijal sme da bude objavljen bez ljudskog pregleda.
Personalizacija će postati multimedijalna, a ne samo tekstualna
Nekada je vrhunac personalizacije bio mejl koji počinje vašim imenom. U eri multimodalnih agenata, video-kampanja u realnom vremenu može menjati jezik, naratora, prikazani proizvod, poziv na akciju (CTA), ambijent i dužinu trajanja, zavisno od profila gledaoca. Jedna osnovna ideja može se granati u hiljade prilagođenih multimedijalnih varijacija, gde se spajaju generisanje sadržaja, CRM baze i marketinška automatizacija.
Iako ovo donosi neverovatan nivo relevantnosti za publiku, sa sobom nosi i ozbiljne rizike od psihološke manipulacije. Ako algoritam precizno zna koje vizuelne i zvučne okidače određena osoba preferira, pa na osnovu toga generiše personalizovano lice, glas i emotivni narativ, postavlja se ozbiljno etičko pitanje gde se završava marketing, a gde počinje manipulacija.
Multimodal AI će ozbiljno promeniti Search
Pretraga se dramatično transformiše. Do juče smo ukucavali tekst ili prilagali fotografiju da bismo pronašli model patika. Sutra možemo snimiti kratak video industrijske mašine koja proizvodi čudan zvuk: sistem će istovremeno videti model sa nalepnice, poslušati akustični profil kvara, pretražiti servisnu dokumentaciju u bazi i ponuditi tačan korak za popravku.
To znači da i optimizacija za pretraživače (SEO) ulazi u novu fazu. Sadržaj na sajtovima više se ne indeksira samo kroz klasične reči. Video, grafike, audio-zapisi i struktura samih dokumenata postaju ravnopravan deo sistema pretrage. Za digitalne izdavače to znači da kvalitetni transkripti, precizni alt opisi, schema podaci i jasno strukturiran sadržaj postaju važniji nego ikada pre.
GEO/AEO era neće ubiti kvalitetan tekst – možda će ga učiniti još vrednijim
Često se čuje pretpostavka da će mogućnost AI-ja da analizira video učiniti pisani tekst nepotrebnim. Situacija je zapravo suprotna. Tekst je najprecizniji, najlakši za citiranje, najbrži za pretragu i najpogodniji za nedvosmislenu proveru činjenica. Multimodalni sistem će rado iskoristiti video da razume vizuelni tok demonstracije, ali će se osloniti na prateći tekst kako bi proverio konkretne podatke i tvrdnje.
Najbolji sadržaj u eri optimizacije za mašinske odgovore (AEO i GEO) biće multimodalno redundantan: vrhunski video praćen detaljnim transkriptom, preciznom grafikom, navedenim izvorima i čistim zvukom. Svaki format pruža specifičnu vrstu signala. Dobar transkript nije koristan samo osobi koja ne može da čuje snimak, već i pretraživaču i AI sistemu koji nastoji da shvati njegovu suštinu.
Multimodal AI je posebno zanimljiv za edukaciju
U obrazovnom okruženju multimodalni pristup donosi revolucionarne pomake. Student može da fotografiše fizičko elektronsko kolo na stolu, postavi pitanje zašto dioda ne svetli, a model će paralelno uporediti fotografiju sa šemom iz priloženog PDF udžbenika i dati konkretan odgovor.
Još bolji primer jeste video-snimak laboratorijskog eksperimenta: sistem može u realnom vremenu da prati redosled koraka, upozori gde je napravljena greška u merenju i odmah generiše kratku animaciju sa pravilnim postupkom. To je interaktivno učenje koje prevazilazi mogućnosti običnih tekstualnih četbotova.
Creative Prototyping će postati gotovo trenutan
Raniji proces razvoja jedne video-reklame zahtevao je nedelje rada: pisanje scenarija, crtanje storiborda, concept art ilustracije i izradu grube animatike. Danas multimodalni sistemi povezuju tekst, crtež, video i zvuk u jedinstvenu celinu za svega nekoliko sati.
Krajnji rezultat ovakvog prototipa ne mora odmah biti spreman za emitovanje (production-ready), ali je potpuno spreman za donošenje ključnih odluka (decision-ready). Umesto da klijent zamišlja kako će izgledati opisana scena, on dobija priliku da pogleda radni prototip i pruži povratne informacije pre nego što počne skupa finalna produkcija.
Cena neuspešnog eksperimenta zato drastično pada
Ovo sa sobom nosi temeljnu ekonomsku promenu: ako tim može da testira deset različitih kreativnih koncepata za samo jedan dan, više nema potrebe da se slepo drži prve ideje samo zato što je u nju već uloženo mnogo vremena. Produkcija postaje prostor za slobodno eksperimentisanje.
Cena video-reklame danas više ne zavisi prosto od minutaže, već od kompleksnosti ideje, broja scena, doslednosti likova, prikaza proizvoda, dizajna zvuka i broja potrebnih formata. Multimodalni alati drastično smanjuju tehničke troškove, ali kreativna složenost i dalje ostaje faktor koji diktira uspeh.
Najveća greška biće očekivati da jedan model radi sve najbolje
Iako multimodalni sistemi na papiru deluju kao univerzalne platforme, u profesionalnom radu specijalizacija ostaje ključna. Jedan model pruža vrhunsku fiziku pokreta u videu, drugi generiše najprirodniji glas, treći je neprikosnoven u retuširanju slike, dok je četvrti superioran u logičkom rezonovanju.
Zato je sloj orkestracije presudan. Korisnik radi unutar jednog preglednog interfejsa, dok u pozadini operiše više specijalizovanih mašina. Praksa u kojoj profesionalni programi omogućavaju izbor različitih podržanih modela unutar istog radnog toka predstavlja jasan pokazatelj smera u kome se industrija kreće.
Vendor lock-in će postati ozbiljan produkcioni rizik
Ako celokupne produkcione procese u kompaniji vežete isključivo za jednog dobavljača modela, izlažete se ogromnom riziku. Šta se dešava ako taj servis naglo podigne cene, izmeni uslove licenciranja, promeni API ili jednostavno ugasi model na koji ste se oslanjali?
Tržište veštačke inteligencije menja se neuporedivo brže od tradicionalnog softvera. Zbog toga profesionalni radni tokovi moraju biti što više nezavisni od konkretnog modela (model-agnostic). Vaša baza treba da čuva detaljne projektne zahteve, reference, promptove, izvorne resurse i metapodatke, dok sam AI model u pozadini mora biti zamenljiv u bilo kom trenutku. Tehnologije dolaze i prolaze, ali proces produkcije mora da ostane stabilan.
AI će moći da napravi više sadržaja nego što iko može da pogleda
Ovde se susrećemo sa verovatno najvećim izazovom digitalnog doba: kada troškovi generisanja sadržaja padnu blizu nule, količina ponuđenih informacija na internetu eksponencijalno raste. Međutim, ljudski dan i dalje ima samo 24 časa, a pažnja publike ostaje strogo ograničen resurs.
Najveća nestašica u digitalnom ekosistemu neće biti sadržaj, već ljudska pažnja. Multimodalni sistem može da generiše stotinu reklama za nekoliko minuta, ali ne može naterati publiku da ih zaista pogleda sa interesovanjem.
Produkcija će pojeftiniti. Distribucija i poverenje mogu poskupeti
U trenutku kada svako može da klikom miša generiše video visokog vizuelnog kvaliteta, sam video prestaje da bude konkurentska prednost. Kada svako ima pristup profesionalnom glasu i fotorealističnim slikama, vizuelni spektakl postaje uobičajena roba široke potrošnje.
Šta onda ostaje kao stvarna vrednost? Originalna ideja, snaga brenda, autorski ukus, integritet i poverenje publike. Zbog toga multimodalni bum paradoksalno podiže cenu prepoznatljivog ljudskog identiteta i karaktera.
„Human-made“ može postati premium oznaka
Slično kao što su se u eri industrijske proizvodnje razvili premijum segmenti za ručno pravljene predmete (handmade), analognu fotografiju ili muzičke nastupe uživo, hiperprodukcija sintetičkog materijala stvoriće publiku koja posebno ceni dokaz o ljudskom poreklu sadržaja.
Stvarna fotografija, autentičan glumac i neobrađen ljudski glas imaće posebnu težinu – ne nužno zato što su tehnički savršeniji od algoritma, već zato što iza njih stoji stvarna biografija, iskustvo i ličnost. Veštački generisan sadržaj će preplaviti svakodnevicu, ali će autentičnost dobiti status novog luksuza.
Multimodalni kreator budućnosti biće više režiser nego operater
Nekada je podela posla bila striktna: fotograf pravi fotografiju, montažer seče kadrove, a kopirajter piše reklamne poruke. Kreator nove generacije funkcioniše znatno bliže filmskom režiseru. Njegov zadatak je da postavi jasan cilj: „Potrebna mi je kampanja koja u prvih pet sekundi demonstrira konkretan problem, zatim prikazuje stvarni proizvod u upotrebi i završava se suptilnim, emotivnim pozivom na akciju.“
Sistem preuzima generisanje i sklapanje elemenata, dok kreativac usmerava tempo, ton i atmosferu. Zanati time ne nestaju – naprotiv, stručnjaci koji suvereno vladaju svojim poslom biće još cenjeniji, jer poseduju znanje i istančan osećaj da prepoznaju kada algoritamsko rešenje nije na potrebnom nivou.
Multimodalna pismenost postaće osnovna digitalna veština
Pismenost je nekada podrazumevala samo čitanje i pisanje, da bi se kasnije proširila na osnovnu digitalnu pismenost. Sledeći evolutivni korak jeste multimodalna pismenost: sposobnost da razumete kako tekst menja vizuelni kadar, na koji način slika diktira dinamiku videa, kako muzika menja emotivni ton i kako veštačka inteligencija sintetizuje sve te signale.
To ne znači da svako mora postati profesionalni montažer, ali razumevanje multimedijalne logike postaće neophodno za marketare, novinare, predavače, dizajnere i menadžere proizvoda.
Budućnost CMS-a neće biti biblioteka fajlova
Tradicionalni sistemi za upravljanje sadržajem (CMS) funkcionišu kao skladišta statičnih fajlova sa pratećim tekstom. Savremeni sistemi, međutim, organizuju se oko samih koncepata: čuvaju kontekst brenda, izvorne materijale, autorska prava, jezičke verzije, izvedene derivate, verifikacione metapodatke i podatke o analitici.
Kada korisnik sa drugog kontinenta zatraži verziju videa prilagođenu za mobilne ekrane na svom jeziku, platforma je generiše u trenutku iz bazičnog koncepta. Sadržaj time prestaje da bude statičan fajl i postaje generativni sistem beskonačnih mogućih reprezentacija.
Od Content Management-a prelazimo prema Content Intelligence-u
Novi sistemi ne beleže samo lokaciju na disku, već u potpunosti razumeju kontekst samog fajla: ko se pojavljuje u kadru, šta je izgovoreno, koji je proizvod prikazan, kakva je emotivna atmosfera scene, da li je logo brenda jasno vidljiv i kakva autorska prava važe za muzičku podlogu.
Ovakav pristup otvara neslućene mogućnosti za automatizaciju, ponovnu upotrebu materijala i inteligentnu pretragu, ali istovremeno pred kompanije stavlja ozbiljne zahteve u pogledu zaštite privatnosti i kontrole podataka.
 Što AI razume više modaliteta, zna više o nama
Fotografija otkriva gde se nalazimo, glas prenosi naše trenutno emotivno stanje, video beleži obrasce ponašanja, dok tekst otkriva naše stavove i način razmišljanja. Kada sistem spoji sve ove izvore u jednu celinu, on gradi izuzetno detaljan profil korisnika.
Zbog toga se multimodalnost ne sme posmatrati isključivo kao zgodna alatka za lakši kreativni rad. Ona predstavlja prvorazredno pitanje zaštite podataka i digitalnog upravljanja, posebno kada se primenjuje u svrhe hiperpersonalizacije, targetiranog oglašavanja i biometrijske analize.
Nije sve što možemo da analiziramo nešto što treba da analiziramo
Tehnička mogućnost modela da iz crta lica, mikropokreta ili boje glasa procenjuje nečije emocionalno raspoloženje nikako ne znači da je ta procena nepogrešiva, niti da je njena upotreba etički opravdana.
Evropski Zakon o veštačkoj inteligenciji (EU AI Act) sa punim pravom postavlja stroga ograničenja i zahteve transparentnosti za sisteme za prepoznavanje emocija i biometrijsku kategorizaciju. Zbog toga će kreativni timovi u budućnosti morati blisko da sarađuju sa pravnim stručnjacima i timovima za upravljanje bezbednošću veštačke inteligencije.
Kako bi mogao da izgleda profesionalni workflow 2030?
Zaboravite na istovremeno otvaranje deset različitih programa. Radni proces biće znatno integrisaniji:
-
Unosite projektni zadatak (brief) u jedinstveni sistem;
-
Prilažete vizuelne smernice brenda, 3D model proizvoda i arhivu uspešnih ranijih kampanja;
-
Zadajete cilj: „Kreiraj novu kampanju za lansiranje usluge“;
-
Sistem generiše tri različita koncepta;
-
Birate drugi predlog uz primedbu: „Ton deluje previše formalno, unesi više opuštene dinamike“;
-
Sistem prilagođava storibord, generiše probni video, bira muzički pravac i sintetizuje naraciju;
-
Nakon vašeg odobrenja, automatizovani agent priprema glavni video, verzije za TikTok i Reels, YouTube formate, statične banere, radio-spot, tekstove za newsletter i prodajnu stranicu, kao i lokalizovane verzije za domaće i strana tržišta – sve uredno snabdeveno verifikacionim metapodacima o poreklu.
Ovo nije naučna fantastika, već realan pravac u kome se industrija kreće: jedinstven sistem u kome više specijalizovanih multimodalnih modela deluje koordinisano pod vođstvom čoveka.
Šta onda radi čovek?
Uloga čoveka u ovakvom okruženju postaje čistija i strateški usmerenija. Čovek:
-
postavlja ciljeve i prepoznaje potrebe publike,
-
bira pravu ideju među stotinama ponuđenih,
-
prepoznaje šta nije dovoljno dobro i koriguje pravac,
-
proverava činjeničnu tačnost i brani integritet brenda,
-
preuzima moralnu i pravnu odgovornost za plasirani rad,
-
donosi ključnu odluku o tome šta uopšte zavređuje da bude ispričano.
Taj strateški i empatijski sloj rada algoritam ne može da zameni.
Multimodal AI neće ukinuti kreativnost – ukinuće opravdanje za generičnost
Kada svako na tržištu za nekoliko trenutaka dobije pristup savršenom filmskom osvetljenju, kristalno čistom glasu i vrhunskim vizuelnim efektima, izgovor da je sadržaj dosadan zato što „nismo imali budžet“ zauvek prestaje da važi.
Konkurentska borba se sa terena tehničkih mogućnosti seli na teren čistog kreativnog kvaliteta. To može delovati zastrašujuće onima koji su se oslanjali samo na puko baratanje softverskim alatima, ali je dugoročno izuzetno lekovito za industriju u celini. Kada veštačka inteligencija svede cenu osnovne zanatske produkcije na minimum, stvarna vrednost originalnog koncepta, autentičnosti i ljudskog autorstva samo raste.
Sadržaj postaje fluidan medij
Digitalni sadržaj je u prošlosti bio strogo vezan za format: tekst je bio u dokumentu, slika u grafičkom fajlu, a video u video-kontejneru. Svaki medij tražio je svoju produkciju, svoju logiku i svoje stručnjake.
Multimodalni AI trajno briše te oštre granice. Tekst postaje slika, slika prerasta u video, video se sažima u tekst, glas se prevodi na drugi jezik, a dokument se transformiše u animaciju. Jedna jedina izvorna ideja može se u trenu manifestovati kroz desetine različitih formata.
Budućnost digitalnog stvaralaštva zato ne leži u pojedinačnim alatima za generisanje teksta, slika ili glasova – to su samo prolazne etape. Suštinska promena leži u fluidnosti sadržaja (Content Fluidity), gde ideja predstavlja postojano jezgro, dok multimodalni sistem po potrebi bira način na koji će je predočiti svetu.
To će doneti neverovatnu brzinu produkcije, laku lokalizaciju i trenutno skaliranje, ali i opasnost od poplave prosečnih, generičkih materijala. Zato ključno pitanje kreativnog sektora uskoro više neće biti: „Da li AI ovo može da napravi?“, jer će odgovor uvek biti potvrdan. Pravo pitanje glasiće: „Zašto bi iko želeo da ovo pogleda, posluša, pročita ili podeli sa drugima?“ Na to pitanje algoritamski benčmark ne daje odgovor. Za to je i dalje potrebno duboko razumevanje ljudske prirode.
Budućnost kreiranja sadržaja ne pripada čoveku koji ignoriše tehnologiju, niti tehnologiji koja radi bez nadzora. Pripada ljudima koji shvataju da multimodalna veštačka inteligencija nije zamena za kreativni proces, već novi prostor u kome se taj proces odvija.
 Često postavljana pitanja (FAQ)
Šta je Multimodal AI?
Multimodal AI je napredni sistem veštačke inteligencije koji ima sposobnost da istovremeno obrađuje, razume i generiše više različitih vrsta podataka – uključujući tekst, slike, video-zapise, zvuk i dokumente – povezujući značenje među njima.
Šta zapravo znači termin modalitet?
Modalitet označava konkretan tip ili oblik informacije kroz koji se komunicira, kao što su tekstualni zapis, statična slika, audio-snimak ili video-kadar.
Da li je svaki generativni AI sistem multimodalan?
Ne. Mnogi modeli su specijalizovani za samo jedan format – na primer, rade isključivo sa tekstom ili isključivo generišu slike. Multimodalni sistemi kombinuju više formata na ulazu, izlazu ili na oba nivoa.
Koja je najveća prednost multimodalne veštačke inteligencije?
Sposobnost da sagleda širi kontekst iz više različitih izvora istovremeno i omogući prirodnu, trenutnu transformaciju sadržaja iz jednog medijskog formata u drugi.
Šta označava pojam cross-modal reasoning?
To je proces mašinskog zaključivanja gde sistem ukršta podatke iz različitih formata – na primer, povezuje vizuelni element primećen na slici sa pravilom opisanim u priloženom tekstualnom dokumentu.
Šta je multimodalni embedding?
To je matematička, vektorska reprezentacija podataka koja omogućava da tekst, slika, audio ili video koji dele isto suštinsko značenje budu smešteni blizu jedan drugog unutar istog digitalnog prostora.
Šta je Gemini Embedding 2?
To je Googleov model za multimodalno mapiranje predstavljen 2026. godine, koji tekst, slike, video, audio i dokumente prevodi u jedinstveni semantički prostor, uz podršku za više od 100 svetskih jezika.
Šta predstavlja Gemini Omni?
To je serija Googleovih naprednih multimodalnih modela (lansirana kroz verziju Omni Flash 2026. godine) koja spaja analizu različitih ulaza sa direktnim generisanjem i uređivanjem videa kroz razgovor.
Može li Multimodal AI da obradi tekst, video i audio u istom trenutku?
Da, savremeni sistemi su građeni upravo sa ciljem da istovremeno primaju i analiziraju više različitih formata unutar jednog radnog zadatka.
Može li veštačka inteligencija zaista da razume kompletan video?
Može da analizira vizuelne promene na sceni, prepozna predmete, transkribuje govor i pročita tekst u kadru, mada krajnja tačnost zavisi od trajanja snimka, kvaliteta rezolucije i složenosti zadatka.
Znači li pojava multimodalnih sistema kraj za inženjering promptova?
Ne u potpunosti, ali se potreba za dugačkim i komplikovanim tekstualnim opisima znatno smanjuje jer željeni pravac sada možemo definisati priloženim vizuelnim ili zvučnim referencama.
Šta je to reference-first način rada?
To je pristup u kome sistemu prvo dajete stvarne primere onoga što želite (fotografije, stilski video, audio-snimak glasa ili dokument sa pravilima), dok kratkim tekstom samo precizirate izmene.
Šta podrazumeva Conversational Editing?
To je proces uređivanja multimedijalnog sadržaja kroz jednostavan razgovor sa sistemom, pri čemu komandama poput „ukloni šum u pozadini“, „spusti ugao kamere“ ili „skrati kadar“ vršite montažu.
Da li se alati za AI generisanje već nalaze unutar profesionalnih programa za montažu?
Da, rešenja poput verzije Adobe Premiere 26.5 imaju ugrađene opcije za direktno generisanje video-isečaka i zvučnih efekata unutar same vremenske linije (Timeline).
Šta je Adobe Generative Media Tool?
To je namenski alat unutar programa Premiere koji korisniku omogućava da označi prazninu u montaži i opiše scenu, nakon čega sistem sam generiše odgovarajući video ili zvuk direktno u projektu.
Može li se u programu Adobe Premiere koristiti više različitih AI modela?
Može. Generative Media Tool omogućava prebacivanje između tehnologije Adobe Firefly i podržanih eksternih modela partnerskih kompanija.
Zašto je rad sa više modela unutar istog softvera važan?
Zato što kreator ne mora da prekida posao, izvozi fajlove i otvara deset različitih spoljnih sajtova i aplikacija da bi iskoristio prednosti različitih generatora.
Šta označava termin Content Transformation?
To je koncept u kome se jedan primarni sadržaj automatski transformiše u veći broj formata – na primer, dugi video postaje tekstualni članak, sažetak za newsletter, kratki video za mreže i audio-podcast.
Koja je razlika između produkcije sadržaja i transformacije sadržaja?
Tradicionalna produkcija svaki medijski format gradi od nule kao odvojen projekat, dok transformacija koristi jedan osnovni resurs i iz njega automatski izvodi sve ostale formate.
Šta je Source Asset?
To je primarni, izvorni materijal ili osnovna ideja (bilo da je u pitanju tekst, audio-snimak ili video) iz koje nastaju sve kasnije verzije i formati.
Može li video-snimak automatski postati kvalitetan članak?
Može. AI model je u stanju da izvuče transkript, prepozna ključne teme i uobliči ih u strukturisan tekst, uz neophodnu uredničku proveru pre same objave.
Može li tekstualni članak da se pretvori u video?
Da. Tekst može poslužiti kao podloga za automatsko generisanje scenarija, sintezu naratorskog glasa, kreiranje ilustracija i sklapanje pratećih video-scena.
Šta je multimodalni RAG?
To je napredni sistem proširenog pretraživanja (Retrieval-Augmented Generation) koji umesto pukog pretraživanja tekstualne baze pretražuje i analizira arhive slika, video-snimaka i audio-zapisa.
Kako multimodalni RAG pomaže poslovanju brenda?
Omogućava sistemu da pretraži celokupnu istoriju jedne kompanije – prethodne kampanje, audio-džinglove, kataloge i vizuelne smernice – kako bi novi sadržaj bio u potpunom skladu sa identitetom brenda.
Kako Multimodal AI menja funkciju CMS platformi?
CMS prestaje da bude pasivno skladište statičnih fajlova i postaje inteligentan sistem koji razume šta se u materijalima nalazi i može samostalno da generiše formate prilagođene specifičnom korisniku.
Šta označava Content Intelligence?
To je nivo informacionog sistema koji ne zna samo naziv i veličinu fajla, već razume njegovu semantiku: ko se nalazi u kadru, šta je izgovoreno, koji su predmeti prisutni i kakva su autorska prava vezana za taj materijal.
Kako multimodalnost utiče na SEO optimizaciju?
Pretraživači dobijaju mogućnost da direktno razumeju vizuelni i zvučni sadržaj, pa kvalitetni metapodaci, transkripti, jasna struktura i semantički opisi postaju još važniji faktor za rangiranje.
Da li multimodalni modeli čine tekstualni sadržaj zastarelim?
Nikako. Tekst ostaje najprecizniji medij za prenošenje činjenica, formulisanje argumenata i laku proveru podataka, te služi kao ključni oslonac za verifikaciju.
Kako multimodalni sistemi utiču na koncepte AEO i GEO?
Sistemi za davanje direktnih odgovora (Answer Engines) mogu da kombinuju različite izvore, pri čemu dobro strukturisan tekst i prateći multimedijalni transkripti znatno olakšavaju mašinsko razumevanje.
Kako se video koristi u modernom e-commerce okruženju uz AI?
Sistem može da analizira video-recenziju kupca, uporedi je sa specifikacijama proizvođača i odmah odgovori na konkretna pitanja novih posetilaca sajta u vezi sa funkcionalnošću artikla.
Na koji način Multimodal AI olakšava rad novinara?
Može trenutno da analizira dugačke snimke, transkribuje izjave, poveže ih sa bazama dokumenata i pripremi predloge naslova i grafika, ostavljajući novinaru više vremena za analizu i proveru činjenica.
Da li se generisani AI materijal sme objavljivati bez provere?
Ne. U profesionalnom novinarstvu i korporativnim komunikacijama ljudska provera ostaje obavezna kako bi se izbegle činjenične greške i pravne posledice.
Šta je multimodalna halucinacija?
To je pojava gde veštačka inteligencija pogrešno protumači detalj sa slike ili zvuka, poveže ga sa netačnim tekstom i na osnovu toga stvori potpuno izmišljen, ali naoko uverljiv zaključak.
Da li fotografija garantuje da je AI ispravno razumeo događaj?
Ne. Algoritam može prepoznati objekte u kadru, ali potpuno pogrešno protumačiti kontekst, vremenski sled ili uzročno-posledične veze među njima.
Šta predstavlja pojam provenance u digitalnom svetu?
To je proverljiva informacija o poreklu digitalnog fajla, koja precizno beleži gde je sadržaj nastao, kojim je alatima kreiran i koje su izmene na njemu izvršene.
Šta su to Content Credentials?
To je industrijski standard razvijen u okviru C2PA koalicije koji služi kao kriptografski potpisani digitalni pasoš za sliku, video ili tekst, beležeći istoriju njegovog nastanka.
Da li prisustvo Content Credentials oznake garantuje da je informacija istinita?
Ne. Ona samo pouzdano dokazuje ko je napravio fajl i da li je na njemu korišćena veštačka inteligencija, ali ne može potvrditi da li je sama tvrdnja izrečena u tom fajlu istinita.
Šta je SynthID?
To je tehnologija digitalnog vodenog žiga koju razvija Google, a koja se nevidljivo ugrađuje u strukturu generisanog teksta, slika, zvuka ili videa radi lakšeg kasnijeg prepoznavanja AI porekla.
Da li evropski Zakon o veštačkoj inteligenciji (EU AI Act) reguliše generisani sadržaj?
Da. Član 50 ovog zakona propisuje jasne obaveze transparentnosti za određene generativne sisteme, a primenjuje se od 2. avgusta 2026. godine.
Mora li svaki generisani fajl imati ogroman vodeni žig?
Ne. Propisi zahtevaju mašinski čitljive oznake i transparentno obaveštavanje korisnika u definisanim situacijama (poput dipfejk materijala ili vesti), ali ne nalažu narušavanje svakog kreativnog rada.
Šta je zapravo deepfake?
To je sintetički generisan ili modifikovan audio-vizuelni sadržaj koji uverljivo imitira stvarne ljude, objekte ili događaje, stvarajući lažan utisak da se nešto zaista dogodilo.
Šta označava pojam model-agnostic workflow?
To je način organizacije posla u kome produkcioni proces nije zavisno vezan za samo jedan AI model, već omogućava laku zamenu alata u pozadini bez poremećaja u radu.
Zašto je važno izbeći preveliku zavisnost od jednog AI sistema?
Cene, licence, stabilnost i kvalitet pojedinačnih modela na tržištu menjaju se izuzetno brzo, pa vezivanje čitavog poslovanja za jedan servis predstavlja veliki poslovni rizik.
Šta je vendor lock-in?
To je situacija u kojoj je prelazak na tehnologiju drugog dobavljača toliko tehnički komplikovan ili finansijski skup da ste praktično prinuđeni da ostanete na postojećem servisu, bez obzira na uslove.
Da li će se u budućnosti pojaviti jedan model koji radi sve?
Iako modeli postaju sve svestraniji, profesionalna produkcija će još dugo kombinovati specijalizovane alate koji pružaju vrhunske rezultate u pojedinačnim oblastima.
Šta predstavlja pojam AI orchestration?
To je proces automatskog usklađivanja, povezivanja i vođenja više različitih modela veštačke inteligencije unutar jednog produkcionog zadatka.
Šta je Agentic Multimodal AI?
To je sistem koji ne samo da opaža svet kroz više modaliteta, već ima sposobnost da samostalno planira, donosi operativne odluke i izvršava složene nizove produkcionih koraka.
Kako izgleda funkcija Creative Agent asistenta?
To je softverski asistent koji može samostalno da analizira projektni zadatak, predloži koncepte, pripremi sirove verzije, montira materijal i ponudi gotove predloge na odobrenje čoveku.
Šta znači koncept Human-in-the-Loop?
To je model rada u kome čovek zadržava kontrolu nad ključnim tačkama procesa, verifikuje tačnost i daje finalno odobrenje pre nego što sadržaj ode u javnost.
Zašto je ljudski nadzor neophodan u automatizovanim sistemima?
Zato što nekontrolisana automatizacija može za kratko vreme da umnoži i plasira ogroman broj sistemskih grešaka pre nego što iko primeti problem.
Kako multimodalni sistemi menjaju personalizaciju komunikacije?
Omogućavaju dinamičko prilagođavanje čitavog vizuelnog, zvučnog i jezičkog izraza konkretnom korisniku, umesto dosadašnje promene samo imena u poruci.
Koji je osnovni rizik hiperpersonalizovanog sadržaja?
Kada sistem poznaje nečije psihološke i emotivne slabosti, personalizovani video i zvuk mogu lako prerasti u sredstvo manipulacije i zloupotrebe poverenja.
Mogu li AI sistemi zaista da prepoznaju ljudske emocije?
Sistemi mogu prepoznati obrasce u tonu glasa i izrazima lica, ali je tumačenje stvarnih unutrašnjih emocija tehnički nepouzdano i nosi ozbiljne etičke i zakonske restrikcije.
Kako Multimodal AI unapređuje proces učenja?
Omogućava učenicima i studentima da postave pitanje pokazivanjem slike problema ili video-snimka, dok sistem odgovara kombinacijom vizuelnih uputstava, animacija i pratećeg teksta.
Hoće li veštačka inteligencija zameniti montažere, dizajnere i fotografe?
Rutinski tehnički poslovi biće u velikoj meri automatizovani, ali će stručnjaci sa istančanim ukusom, razumevanjem estetike i sposobnošću strateškog vođenja projekata postati još traženiji.
Šta je Creative Judgment?
To je sposobnost prepoznavanja istinski kvalitetne, autentične i funkcionalne ideje među desetinama generičkih predloga koje nudi mašina.
Zašto ova veština postaje toliko važna?
Zato što je samo generisanje sadržaja postalo jeftino i dostupno svima, pa se prostor razlikovanja seli na kvalitet selekcije i konačne odluke.
Da li će veštačka inteligencija pojeftiniti profesionalnu produkciju?
Smanjiće tehničke troškove izrade prototipa i rutinskih radnji, ali vrhunski projekti i dalje zahtevaju strategiju, ekspertizu, proveru kvaliteta i autorsko vođstvo.
Šta označava Time to First Viable Version?
To je vreme koje protekne od prve ideje do stvaranja prvog dovoljno dobrog prototipa na osnovu koga se može doneti odluka o daljem pravcu projekta.
Zašto je to važan parametar?
Zato što omogućava brzo testiranje ideja, rano dobijanje povratnih informacija i jeftino odbacivanje koncepata koji u praksi ne funkcionišu.
Da li preti opasnost od hiperprodukcije digitalnog sadržaja?
Da. Količina plasiranog sadržaja već raste neuporedivo brže od kapaciteta ljudske pažnje, što dovodi do zagušenja digitalnog prostora.
Šta znači žargonski izraz AI slop?
To je naziv za masovno proizveden, generički, nekvalitetan i bezvredan sadržaj koji je napravljen isključivo radi popunjavanja prostora na internetu.
Kako se autor može istaći u moru generičkog sadržaja?
Fokusiranjem na jedinstvene ideje, lično iskustvo, proverenu ekspertizu, prepoznatljiv stil i izgradnju stvarnog poverenja sa publikom.
Može li oznaka „human-made“ postati garant kvaliteta?
Vrlo verovatno. Kako digitalni prostor bude preplavljen sintetičkim materijalima, publika će sve više ceniti dokaz da iza dela stoji stvarna ljudska ruka i autentičan glas.
Koje su ključne veštine za kreativce nove generacije?
Kreativna direkcija, pripovedanje (storytelling), kritičko razmišljanje, multimodalna pismenost, upravljanje AI procesima i sposobnost provere činjenica.
Šta zapravo podrazumeva multimodalna pismenost?
To je sposobnost razumevanja načina na koji različiti mediji – tekst, slika, zvuk i pokret – međusobno sarađuju u prenošenju jasne poruke.
Šta predstavlja najveću promenu u svetu digitalnih medija?
Prelazak sa statičnih, zapečaćenih fajlova na fluidne baze znanja iz kojih se format dinamički stvara u skladu sa trenutnim potrebama korisnika.
Koji je osnovni princip uspešne multimodalne produkcije?
Nemojte koristiti tehnologiju samo zato što vam omogućava da napravite više formata odjednom. Koristite je kako bi prava ideja dobila najbolji oblik, tačan kontekst i stigla u pravo vreme – uz svest da čovek ostaje jedini garant njene stvarne vrednosti.